Article · Writing
讓「不禮讓行人」變成可回看的事件:YOLOv8 × DeepSORT
一個大學畢業專題如何把交通影片的物件偵測、跨畫面追蹤與場景規則串成可回看的候選事件,並在哪些地方仍不能宣稱準確率或生產就緒。
Evidence trail
Provenance
這篇內容的 canonical URL 是 /writing/yolo-right-of-way-detection/,發布日期為 2026年8月1日。
相關 Project 證據與實作:https://github.com/Tommyweige/Yolo-Pedestrian-Detection-for-Right-of-way-Recognition
相容的歷史路徑:/posts/yolo-right-of-way-detection/

文章目錄
雨天街景裡,車輛、行人和斑馬線可能同時出現在一格畫面中;但「這台車是否在行人通過時讓行」不是單格影像能直接回答的問題。YOLO Right-of-Way Recognition 這個大學畢業專題的核心嘗試,是把一段影片轉成可以回看、檢查、討論的候選事件,而不是把一張圖片的框線直接當成交通違規判決。
本文是這個 Project 的 Overview Article:先說明畫面裡的事件如何形成,再回到真實的桌面操作、輸出影格與證據邊界。專案在作品集裡被標為 Featured,是因為它代表一段完整的學術與工程作品;這個標記不等於已驗證的偵測準確率或 production readiness。
為什麼單格偵測不夠?
影片進入系統後,YOLOv8(You Only Look Once 第 8 版)會在每一格畫面裡找出行人、車輛、機車和斑馬線;這一步是物件偵測,輸出是帶有類別與位置的框線。單格結果能回答「這裡可能有什麼」,卻不能回答「前後畫面的同一台車怎麼移動」。
因此專案再使用 DeepSORT(Deep Simple Online and Realtime Tracking)。它是一種跨畫面追蹤方法,會替偵測到的物件保留 ID,也就是識別同一個物件的編號,讓程式能把前後畫面的 car:6 視為同一個追蹤對象,而不是每格都重新編號。最後,場景規則把物件位置、斑馬線區域、車輛方向與移動軌跡放在一起,才形成「可能未禮讓」的提示。
這個分工很重要:YOLOv8 負責看見物件,DeepSORT 負責維持跨畫面的身份,規則層負責把連續觀察轉成事件提示。畫面上的 Fail to yield to pedestrians 不是 YOLOv8 單獨預測的類別,也不是法律判定。
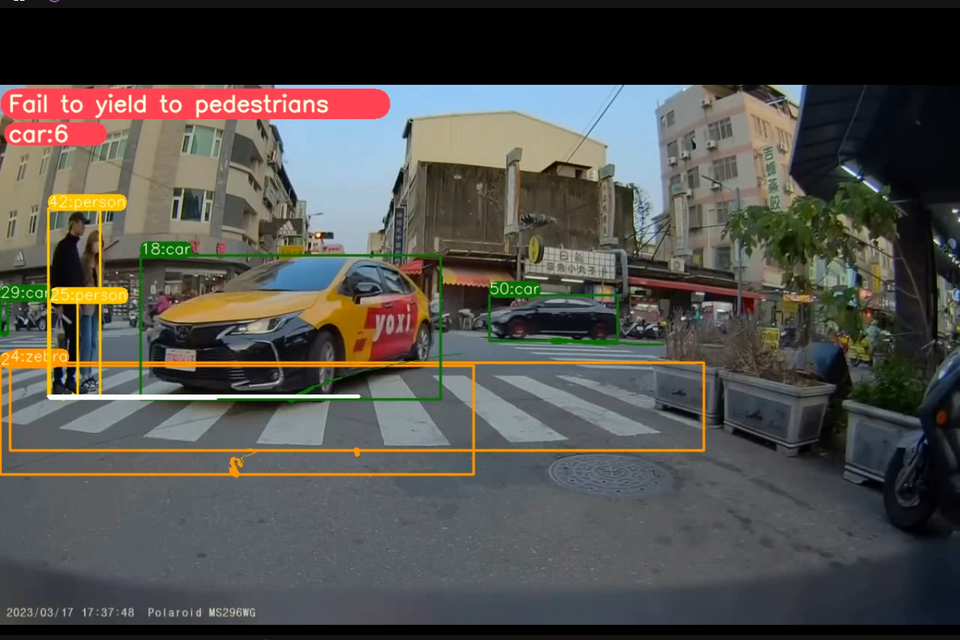
輸出影片的真實影格:框線、物件 ID、斑馬線區域與 Fail to yield to pedestrians 同時出現。這張影格支持「系統能把偵測、追蹤與規則結果疊回影片」;它不能支持整體準確率或所有道路情境都有效。影像是本 Project 原始展示素材,實作與執行方式見 GitHub repository。
使用者實際怎麼跑一次分析?
這不是只能從命令列呼叫的模型。README 和 controller.py 所描述的桌面流程,把輸入、模型、輸出與進度放在同一個 PyQt5 介面中。一次分析大致會經過:
選取一個或多個 .mp4、.avi 或 .mkv 影片,指定輸出資料夾,再從 yolov8s、yolov8l、yolov8x6 中選擇模型。README 以速度與辨識能力描述這三個選項的取捨;專案沒有在公開頁面提供可比較的評估基準(benchmark),所以不能把這些標籤寫成實測準確率。
接著使用者可以選擇兩種模式:闖紅燈偵測,或車輛不禮讓行人偵測。若影片角度不適合規則判斷,也可以先在校正頁調整旋轉角度,再把校正後的畫面交給後續流程。處理單部或多部影片時,介面會顯示目前影片和全部影片的進度。
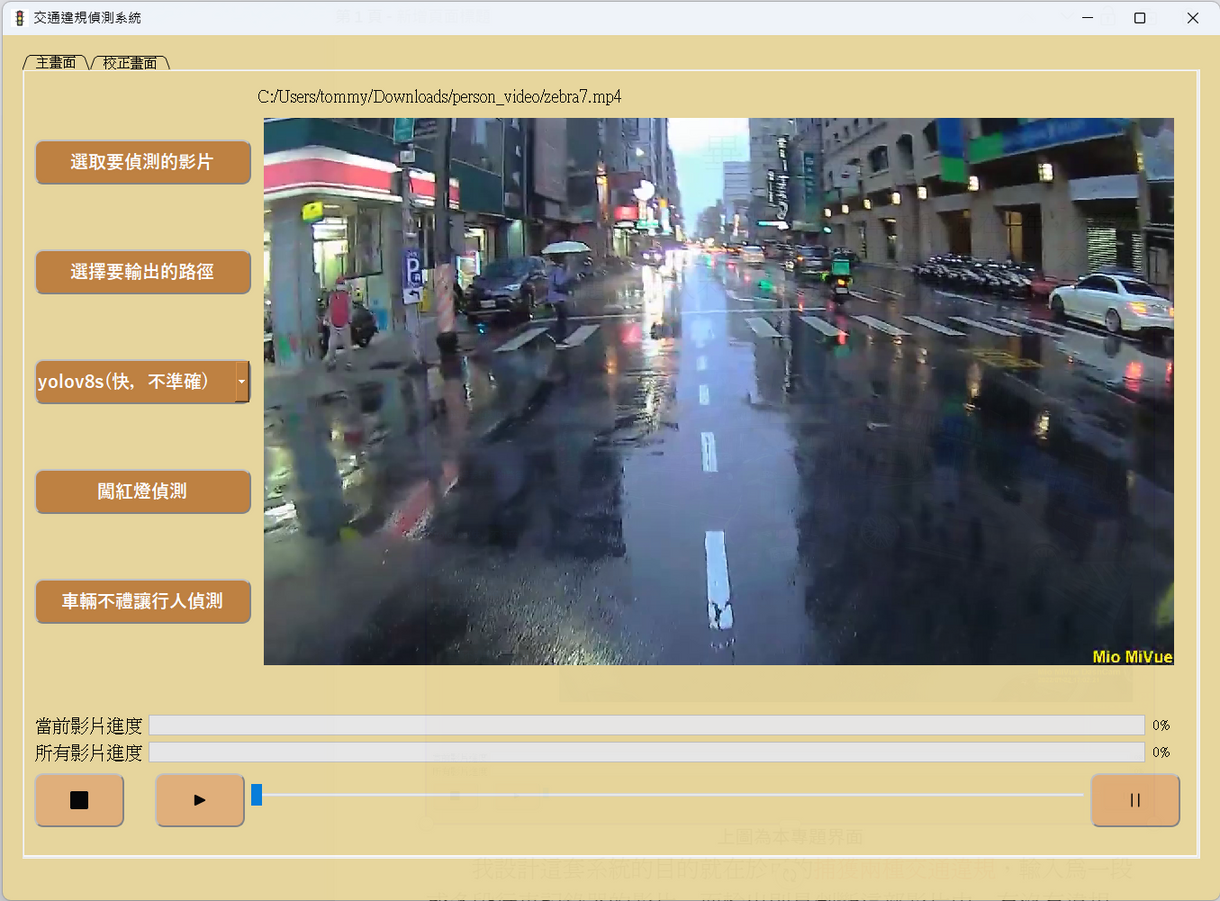
真實桌面介面:載入 zebra7.mp4 後,同一個視窗提供影片預覽、輸入選擇、模型選單、偵測模式與播放控制。它證明的是可操作的 user workflow,不是模型品質評估。來源為本 Project 的原始展示素材,核心程式見 repository 的 README 與 controller.py。
角度校正解決了什麼?
角度校正不是讓模型突然變準,而是先把輸入影像轉成比較符合場景規則假設的方向。對斑馬線區域、道路方向與物件位置而言,這能減少「畫面歪了,規則也跟著難以解讀」的操作問題。
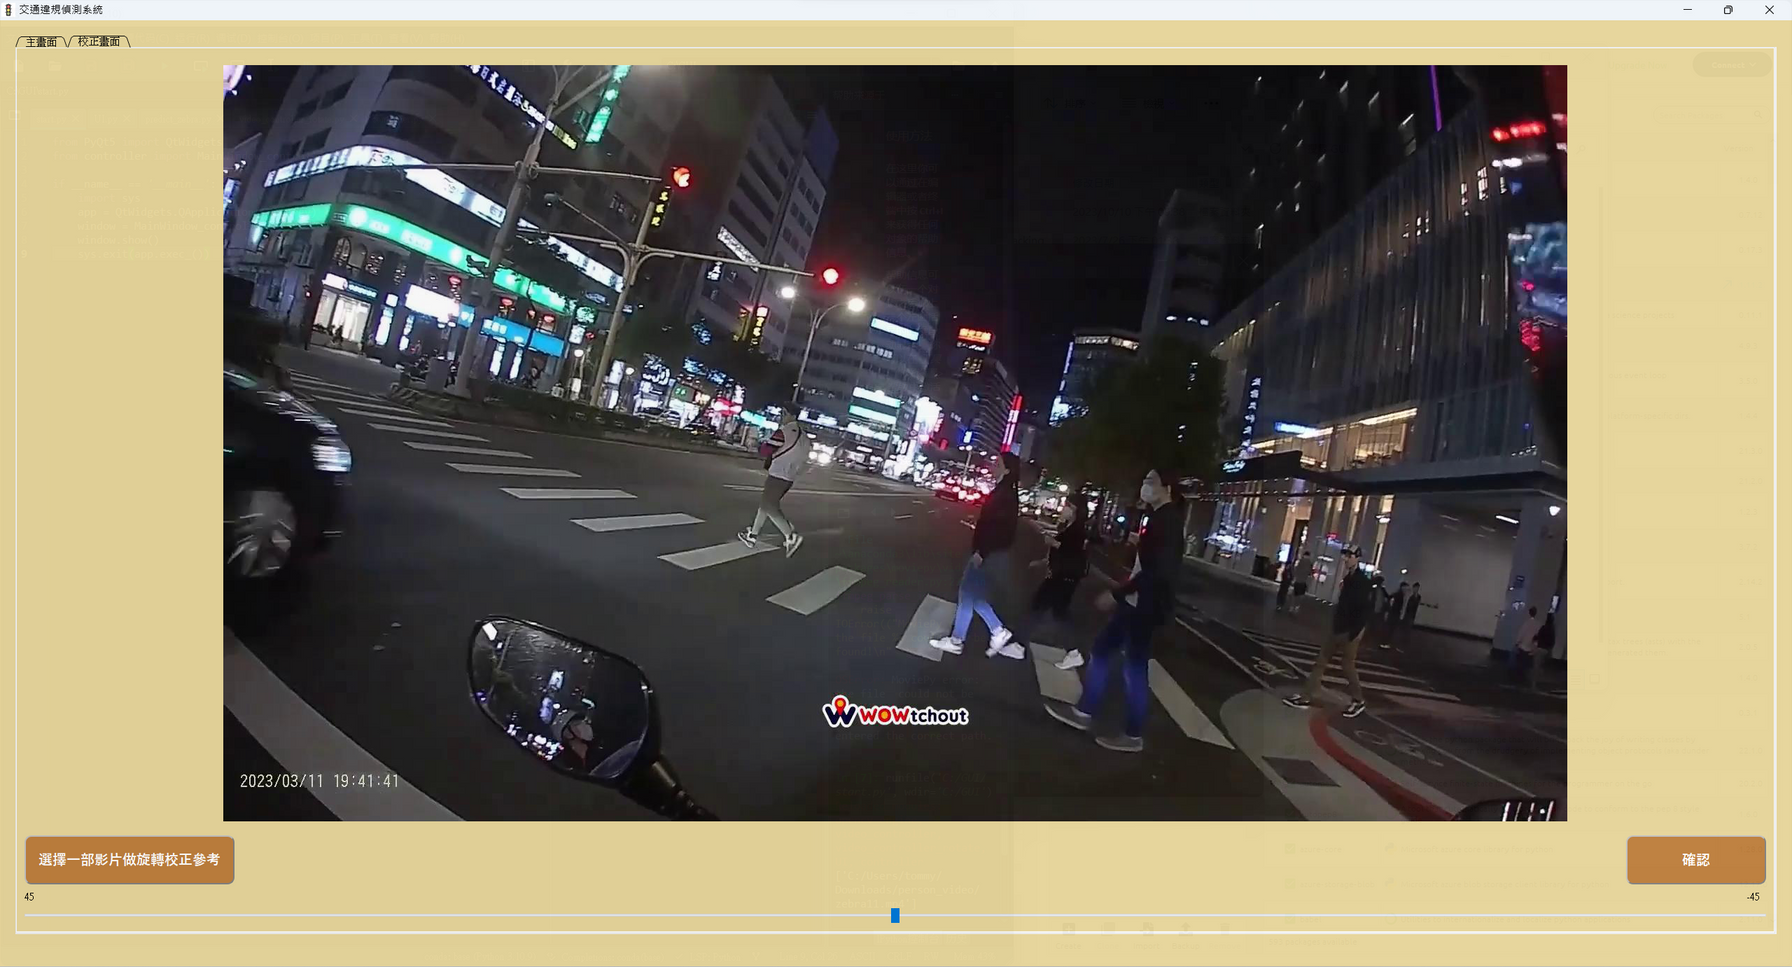
旋轉校正前的真實影片畫面;它是輸入條件,不是偵測結果。
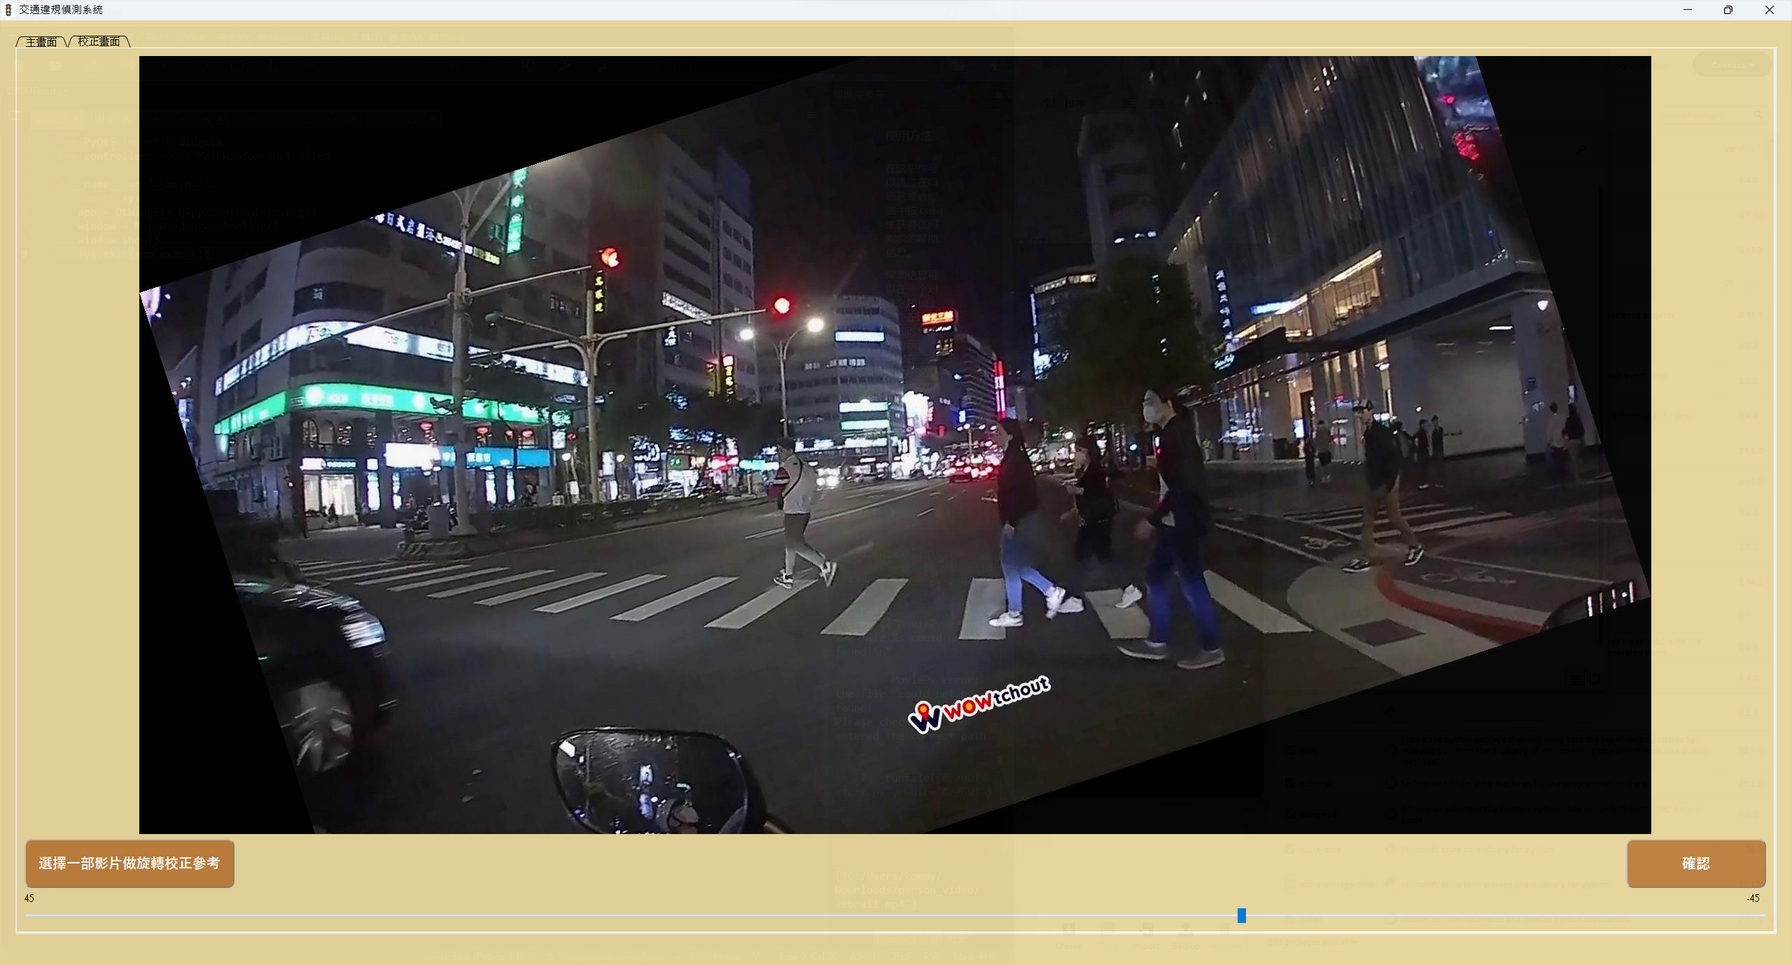
旋轉校正後的真實畫面;它展示輸入前處理的效果,不代表後續事件判斷一定正確。兩張校正影像都來自同一組 Project 展示素材,旋轉功能的實作入口可在 controller.py 查閱。
開始處理後,預覽畫面會顯示目前的影片狀態,單部影片與整批影片的進度列也會更新。這裡的進度條是使用者工作流證據:它顯示程式把影片處理當成可觀察的批次工作,而不是直接證明輸出內容的正確性。
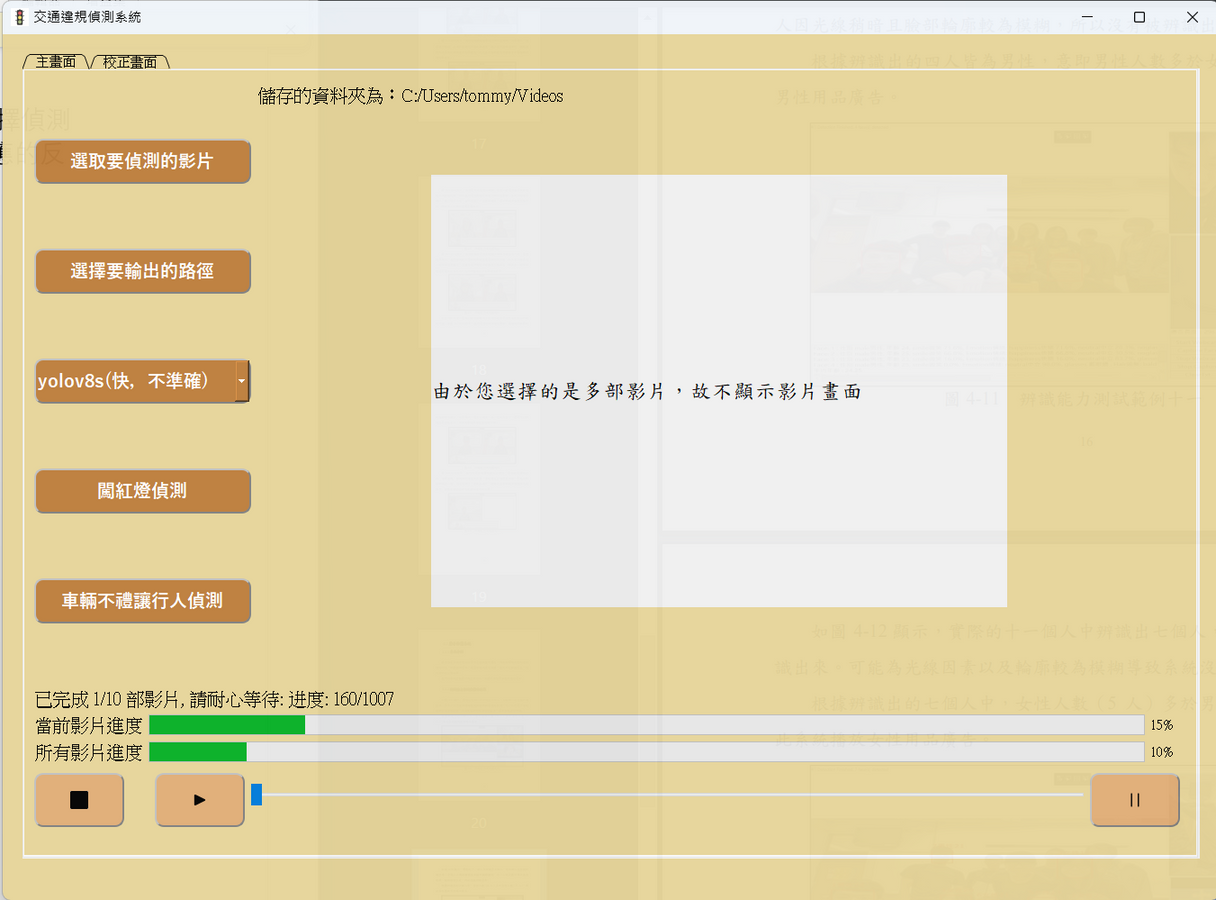
執行中的真實介面:目前影片與整批影片的處理進度同時可見。來源為 Project 展示素材;輸出內容仍需回看影格與原始影片比對。
什麼證據能支持這個故事?
目前最直接的證據是三類真實輸出:桌面介面截圖、旋轉校正前後的影像,以及輸出影片中的偵測影格。它們回答的是不同問題:介面截圖說明使用者如何操作,校正影像說明輸入如何被整理,輸出影格說明偵測與規則結果如何被寫回影片。
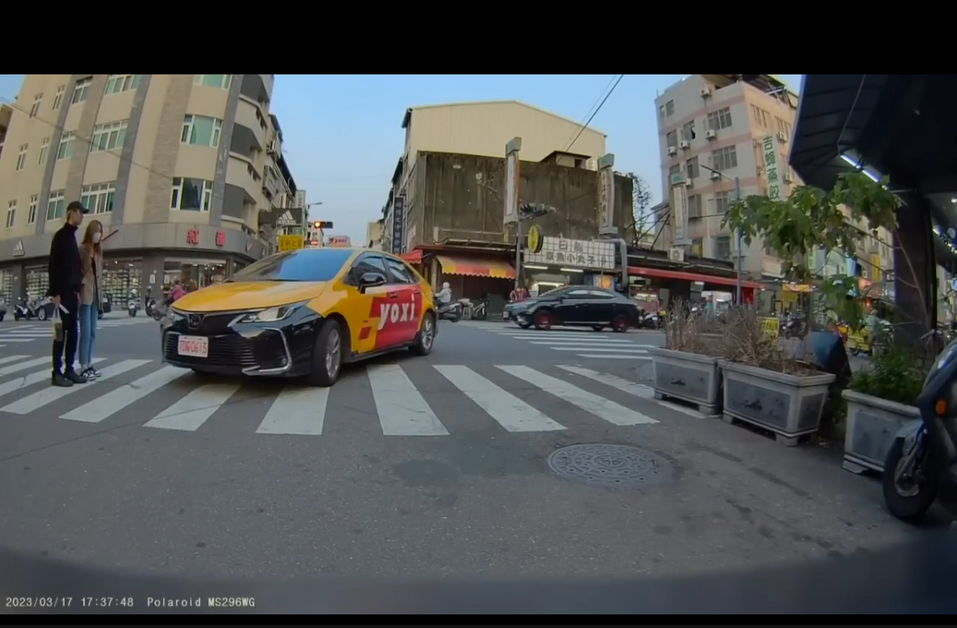
輸出前的原始影片影格:它提供和結果影格比較的基準。
白天與夜間畫面也保留了不同光線條件下的展示素材。它們適合用來觀察輸出標記在不同畫面上的可讀性,但不是系統化的 night-time benchmark。
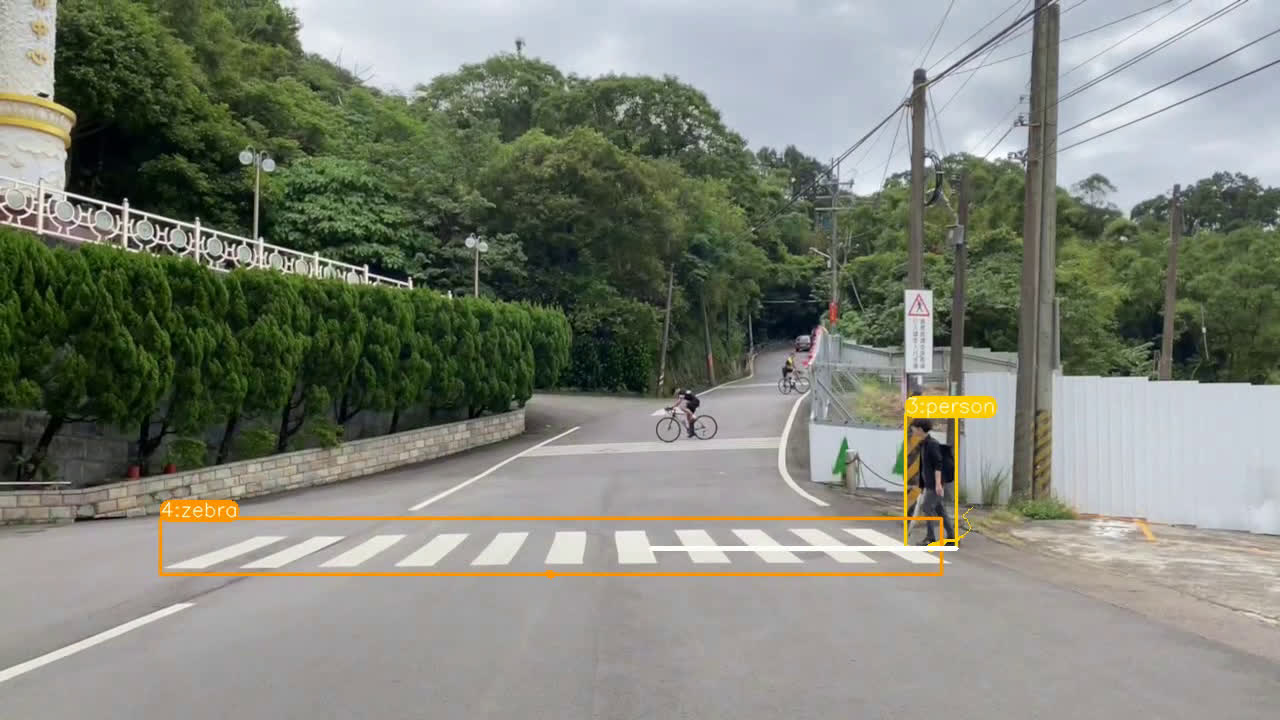
日間道路場景的真實輸出影格;可觀察框線與事件提示如何疊回畫面。
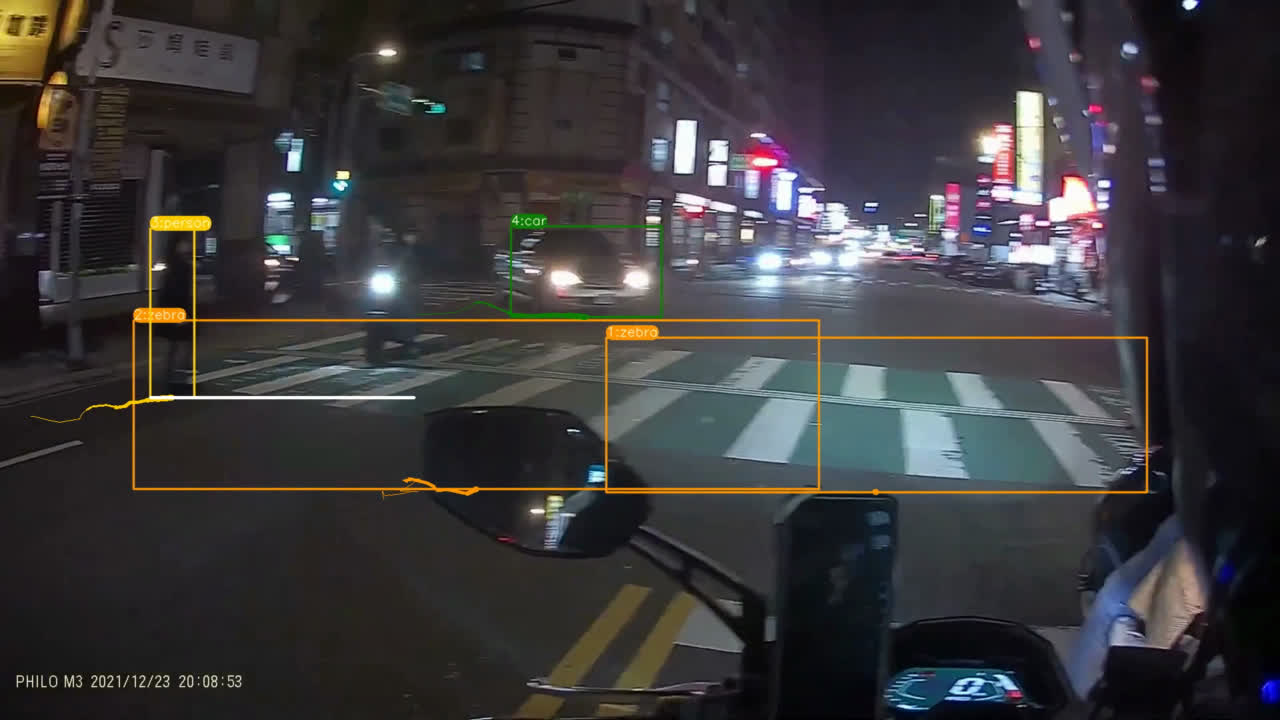
夜間道路場景的真實輸出影格;它讓讀者看到另一種光線條件,但不代表夜間表現已被量化驗證。
輸出影片中的影格則更直接展示跨畫面的追蹤結果:同一個車輛或行人會在連續畫面裡保留 ID。這些影格能幫助讀者理解「追蹤」和「單格偵測」的差別;它們仍然只是實際案例,不是完整影片集合的統計評估。
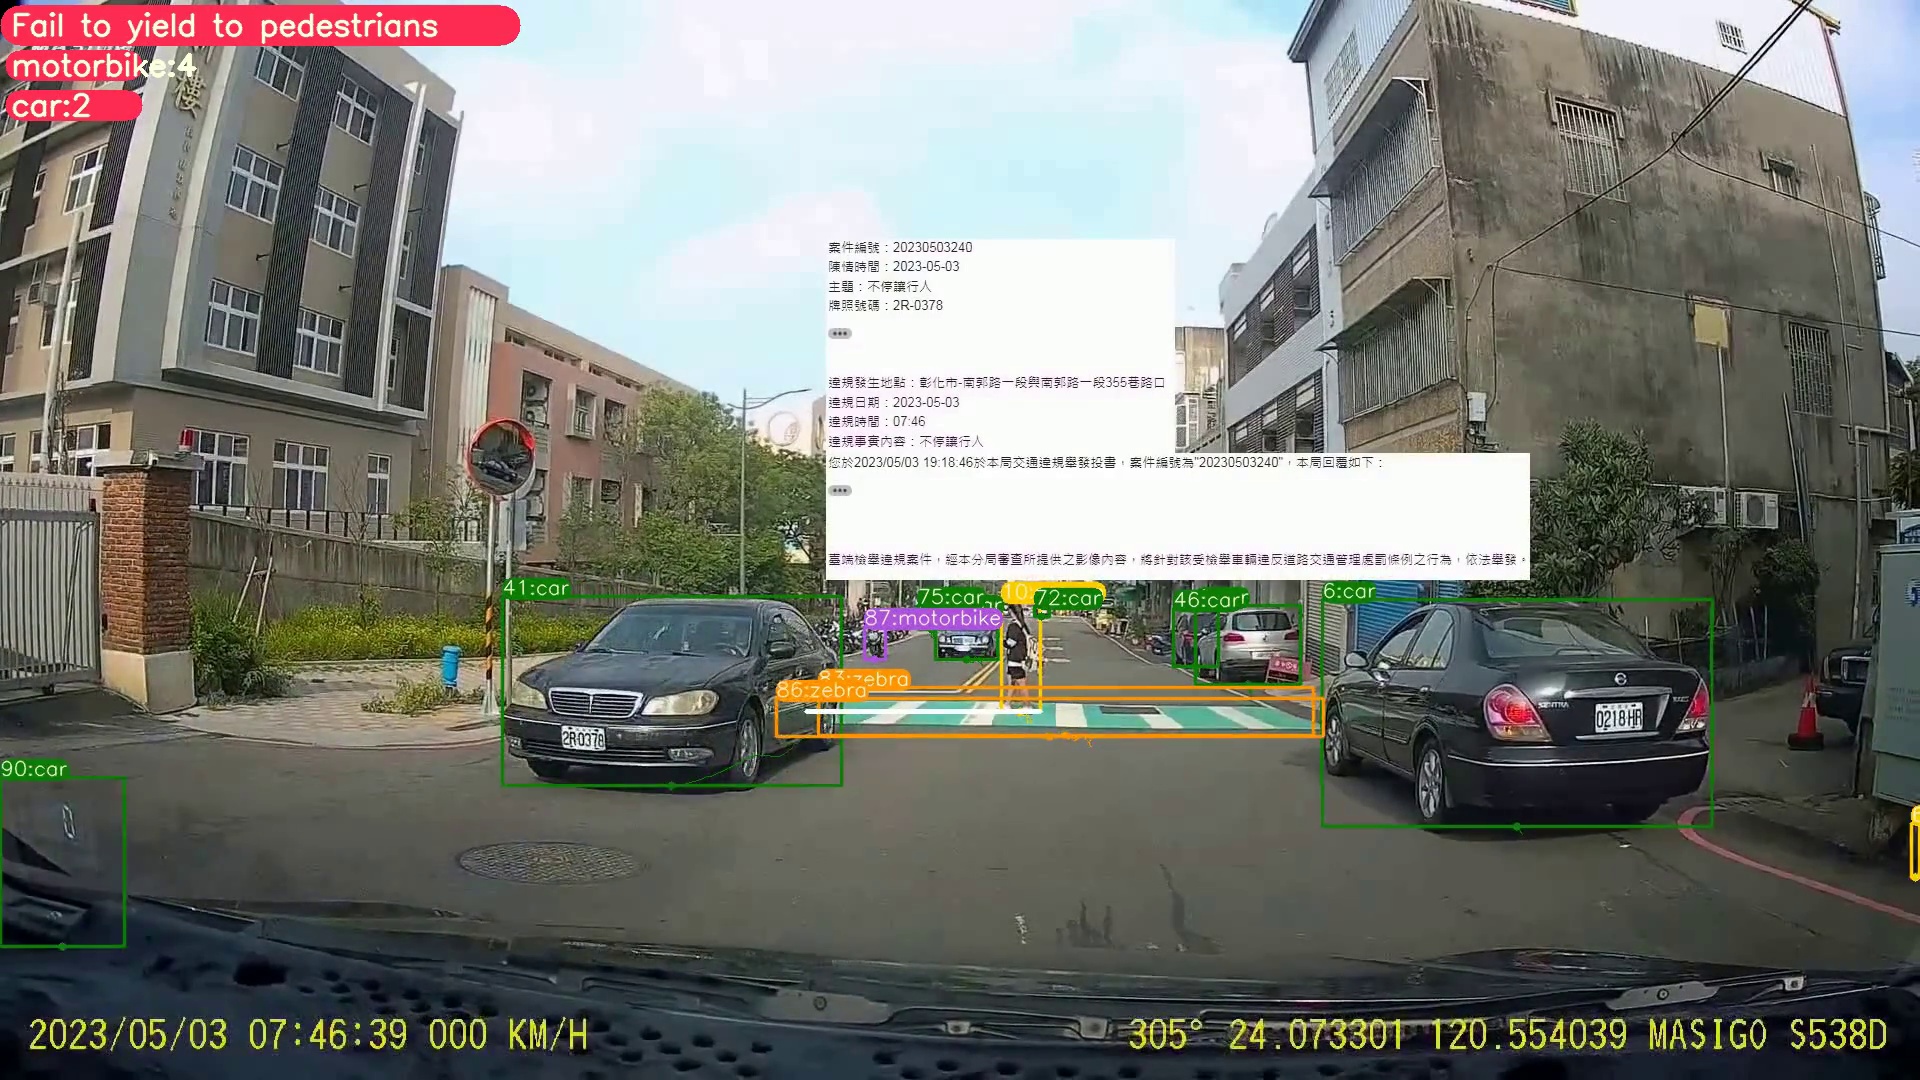
日間輸出影片的真實影格:可看到物件 ID、偵測框與事件提示共同出現。

斑馬線場景的真實輸出影片影格:可觀察車輛、行人與斑馬線區域在同一個事件判斷裡如何被保留。
原始專案 repository 目前提供程式、README 與執行依賴,但沒有公開可直接播放的影片 URL、標註測試集或完整評估表。因此本文選擇嵌入真實影片影格,而不把不存在的 hosted demo 寫成可點擊產品;要重現流程,讀者應依 repository 的 Python 3.9 與依賴說明準備本機環境,再用自己的影片輸入。
這些畫面沒有證明什麼?
這組 Project 證據有清楚的邊界。Repository 沒有附上可供核對的 precision(預測為事件的結果有多少是真的)、recall(實際事件有多少被找出)、混淆矩陣、標註資料切分或跨場景評估基準,所以不能從幾張成功影格推導「準確率很高」。Fail to yield to pedestrians 是在特定輸入、模型權重、門檻與場景規則下產生的候選提示,仍需要人回看原始影片;它不是法律或執法結論。
此外,程式目前依賴本機 Python、模型權重與桌面環境,source 中也保留了針對原作者電腦的路徑設定。這代表它是完成的 capstone prototype 與可研究的工程作品,不是已處理部署、維運、隱私、責任歸屬與所有道路條件的 production system。
回頭看,真正完成的是哪一層?
這個專題最可驗證的成果,不是某個沒有評估協議支撐的單一分數,而是把一個模糊的交通問題拆成可以觀察的工作流:先定位物件,再保留跨畫面身份,接著把場景規則套在連續觀察上,最後讓使用者檢查輸出影片。這個拆分也指出了下一個自然問題:如果要把「看起來能運作」提升成可信的偵測系統,下一步必須建立標註資料、固定測試切分、定義事件判定與誤報/漏報指標,再用多種道路與光線條件驗證。
延伸閱讀與可重現入口
- GitHub repository — Yolo-Pedestrian-Detection-for-Right-of-way-Recognition:原始程式、README、依賴與模型推論入口。
- Project Profile:Featured 狀態、Project Outcomes、Evidence Trail 與本 Overview Article 的關係。