Article · Writing
擴展 DQN 訓練系統:向量化、模型變體與公平比較
從向量化訓練到 DQN、Double DQN 與 Dueling Double DQN 的 staged comparison,說明在有限計算下如何保留可比較性,也說明為什麼較高分不等於已經證明模型更好。
Evidence trail
Provenance
這篇內容的 canonical URL 是 /writing/scaling-dqn-training-and-variants/,發布日期為 2026年9月22日。
相關 Project 證據與實作:https://github.com/Tommyweige/breakout-rl-engineering
這篇內容也保留在其 Series 關係中;正文不需要依賴前一篇才能閱讀。
相容的歷史路徑:/posts/scaling-dqn-training-and-variants/
文章目錄
強化學習裡,「把訓練跑快」和「把模型比較清楚」是兩個不同的工程問題。GPU 可能因為一次只處理一個 observation 而閒置;模型也可能因為 random seed、checkpoint budget 或 evaluation 規則不同,而得到看似漂亮卻不能直接比較的分數。
Original Breakout Ironman 的 Days 16–21 正好把這兩個問題接在一起:先用向量化環境改善資料流,再比較 Vanilla DQN、Double DQN 與 Dueling Double DQN,最後用 staged training、模型選擇與 holdout evaluation 決定哪個 checkpoint 值得保留。
本文要回答的問題是:在有限計算下,如何讓訓練系統變快,同時讓 DQN 變體的比較仍然公平、可追溯,而且不把混合結果寫成單一 winner 故事?
先把「訓練變快」和「模型變好」拆開
單一 Breakout 環境的資料流很容易變成一個小工作循環:產生一張 observation、做一次 batch=1 的 forward、讓 CPU 執行一步遊戲,再寫入一筆 transition。向量化環境則同時管理多個彼此獨立的 Breakout,把多張 observation 組成 batch,讓一次 forward 產生多個 action。
這個改動的重點不是「多開幾個環境就一定更好」,而是重新安排固定成本。Day 16 在相同的 100K transition budget 下比較了不同數量的環境:
| Backend | Throughput | 約需 wall-clock |
|---|---|---|
| N=1 | 238.67 transitions/s | 419.00 s |
| N=2 | 380.74 transitions/s | 262.65 s |
| N=4 | 368.06 transitions/s | 271.70 s |
N=2 相對 N=1 約為 1.60×。短跑的 10K screening 中,N=8 曾得到 483.30 transitions/s,但拉長到 100K 後,N=2 才是這台 RTX 4060 Laptop GPU 上較合理的折衷。這也是為什麼 systems screening 不能只看一次短跑的最大值。
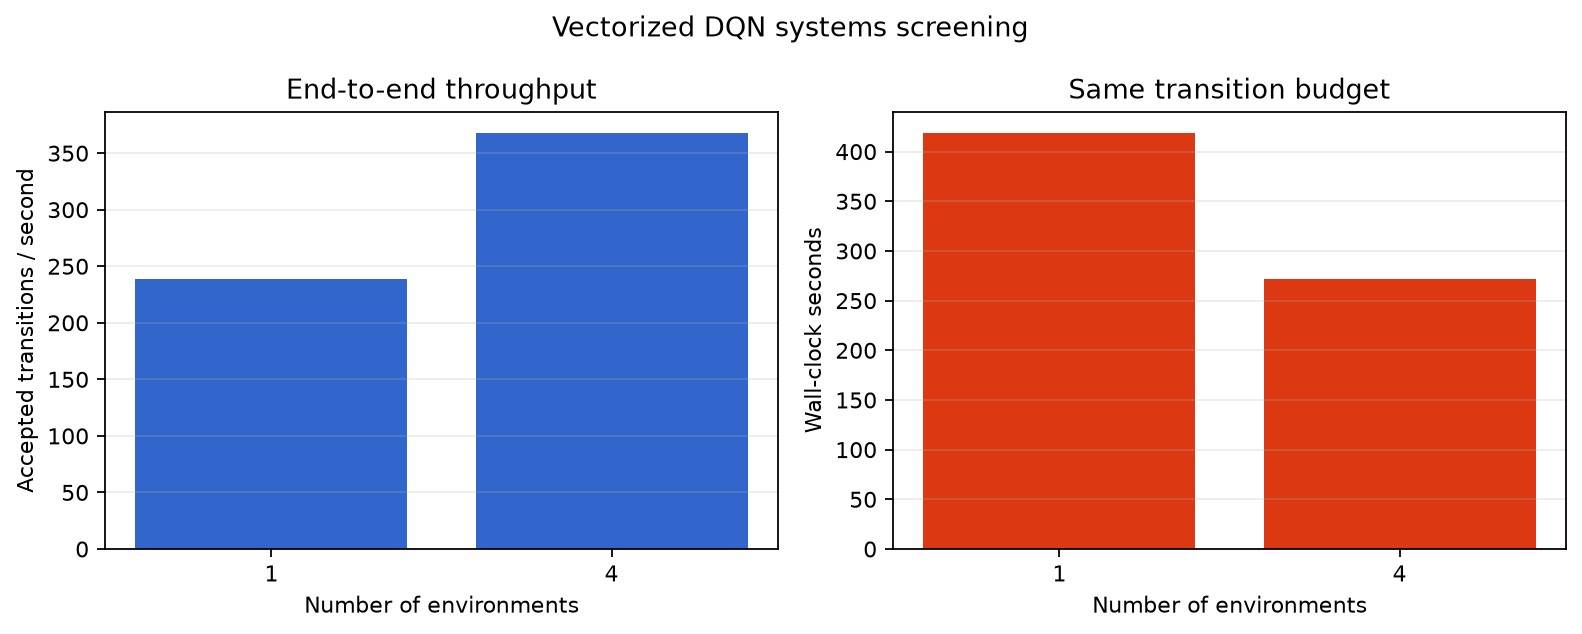
圖 1:完整 trainer 的 throughput 需要和固定 transition budget、實際 wall-clock 一起看;來源:Day 16 artifact。

但速度不是 policy quality。Day 16 對 100K checkpoint 使用同一套 Contract v2、固定 15 個 evaluation seeds、epsilon=0 與 raw Atari reward 評估時,N=1 的平均 return 是 9.00,N=2 是 6.07,N=4 是 2.33。N=2 因此被選為後續的 systems backend,不是因為它已經證明會產生最好的模型,而是因為它用較少時間完成相同的資料量;N=1 則保留成 model-quality reference。
這個區分會貫穿後面的比較:吞吐量是工程成本,evaluation return 是模型品質;兩者不能互相代替。
從 DQN 到 Double 與 Dueling:每個變體改了什麼
Vanilla DQN 在下一個 state 上直接計算:
target = reward + gamma * max Q_target(next_state, action)
當每個 Q-value 都帶有估計誤差時,直接取最大值容易把剛好偏高的估計保留下來。Double DQN 把兩個工作拆開:由 online network 用 argmax 選 action,再由 target network 評估那個已選 action。它不是保證 Q-value 從此正確,而是降低同一份 noisy estimate 同時負責選擇與評估的高估傾向。
Dueling Double DQN 再改變 network representation:保留 Double DQN 的 target rule,並把最後的表示拆成 state 的共同 Value 與各 action 的 Advantage,再重建 Q-values。這讓三個 family 的差異可以先用一句話表示:
| Family | 主要改動 |
|---|---|
| DQN | 直接學每個 action 的 Q-value |
| Double DQN | 分開「選 action」與「評估 value」 |
| Dueling Double DQN | 保留 Double target rule,並拆分 Value 與 Advantage 表示 |
這些名稱描述的是方法,不是成果保證。真正的問題是:在同一個 environment contract、backend、transition budget 和 evaluation protocol 下,它們的差異是否仍然存在?
先寫清楚比較單位,再跑正式比較
Day 18 到 Day 20 把可比較性當成實驗條件,而不是結果出來後才補的說明。主要條件固定為:
- environment:
ALE/Breakout-v5,遵守 Breakout Contract v2; - training backend:相同 CUDA backend、相同主要 training config 與 transition budget;
- formal training seeds:
11 / 22 / 33; - checkpoint evaluation:相同規則下各跑 15 局,使用 raw Atari reward;
- staged budget:先用 100K 確認是否開始學,再觀察 250K,於 500K 做三個 training seed 的正式比較。
這裡的獨立比較單位是 training seed,不是 evaluation episode。每個 model family 的一個 seed 會產生一個 training trajectory 與 checkpoint;同一 checkpoint 的 15 局只是用來估計它在固定測試條件下的 episode-level return 分布。把 15 局當成 15 個獨立 training replicate,會嚴重放大證據量。
另外,500K 以前的 staged runs 會從 checkpoint 接續,但 replay buffer 沒有完整保存,resume 後需要重新 warm up。DQN、Double DQN 與後續 top-2 extension 使用相同規則,所以仍可做相對比較;但這些結果不能被描述成一條完全不中斷、從 0 跑到 1M 的單一 run。
500K 的結果:Dueling 暫時領先,但方向還不完全一致
Day 18 先比較 DQN 與 Double DQN。在 500K、三個 training seeds、每個 checkpoint 15 局 fixed evaluation 下,Double DQN 的平均分分別比 DQN 高 2.73、3.27 與 0.93。這支持一個有條件的結論:在這個 Contract v2、CUDA backend 與這三個 seeds 下,Double DQN 的方向一致較高;它不支持「Double DQN 對所有 Atari、seed 與超參數都一定較強」。
加入 Dueling Double DQN 後,500K 的完整 family table 是:
| Family | seed 11 | seed 22 | seed 33 | 三個 seed 平均 |
|---|---|---|---|---|
| DQN | 14.267 | 13.000 | 20.267 | 15.844 |
| Double DQN | 17.000 | 16.267 | 21.200 | 18.156 |
| Dueling Double DQN | 21.133 | 19.400 | 20.000 | 20.178 |
如果只看平均數,順序是 Dueling > Double > DQN。但把 Dueling 和 Double 用相同 training seed 配對後,差值是:
seed 11: +4.133
seed 22: +3.133
seed 33: -1.200
seed 33 反而由 Double DQN 較高。因此 500K 的正確摘要不是「Dueling 已經勝出」,而是:Dueling 暫時領先,但三個 paired seeds 尚未支持完全一致的方向。 這個混合結果正是延長比較的理由,而不是應該被刪掉的尷尬細節。
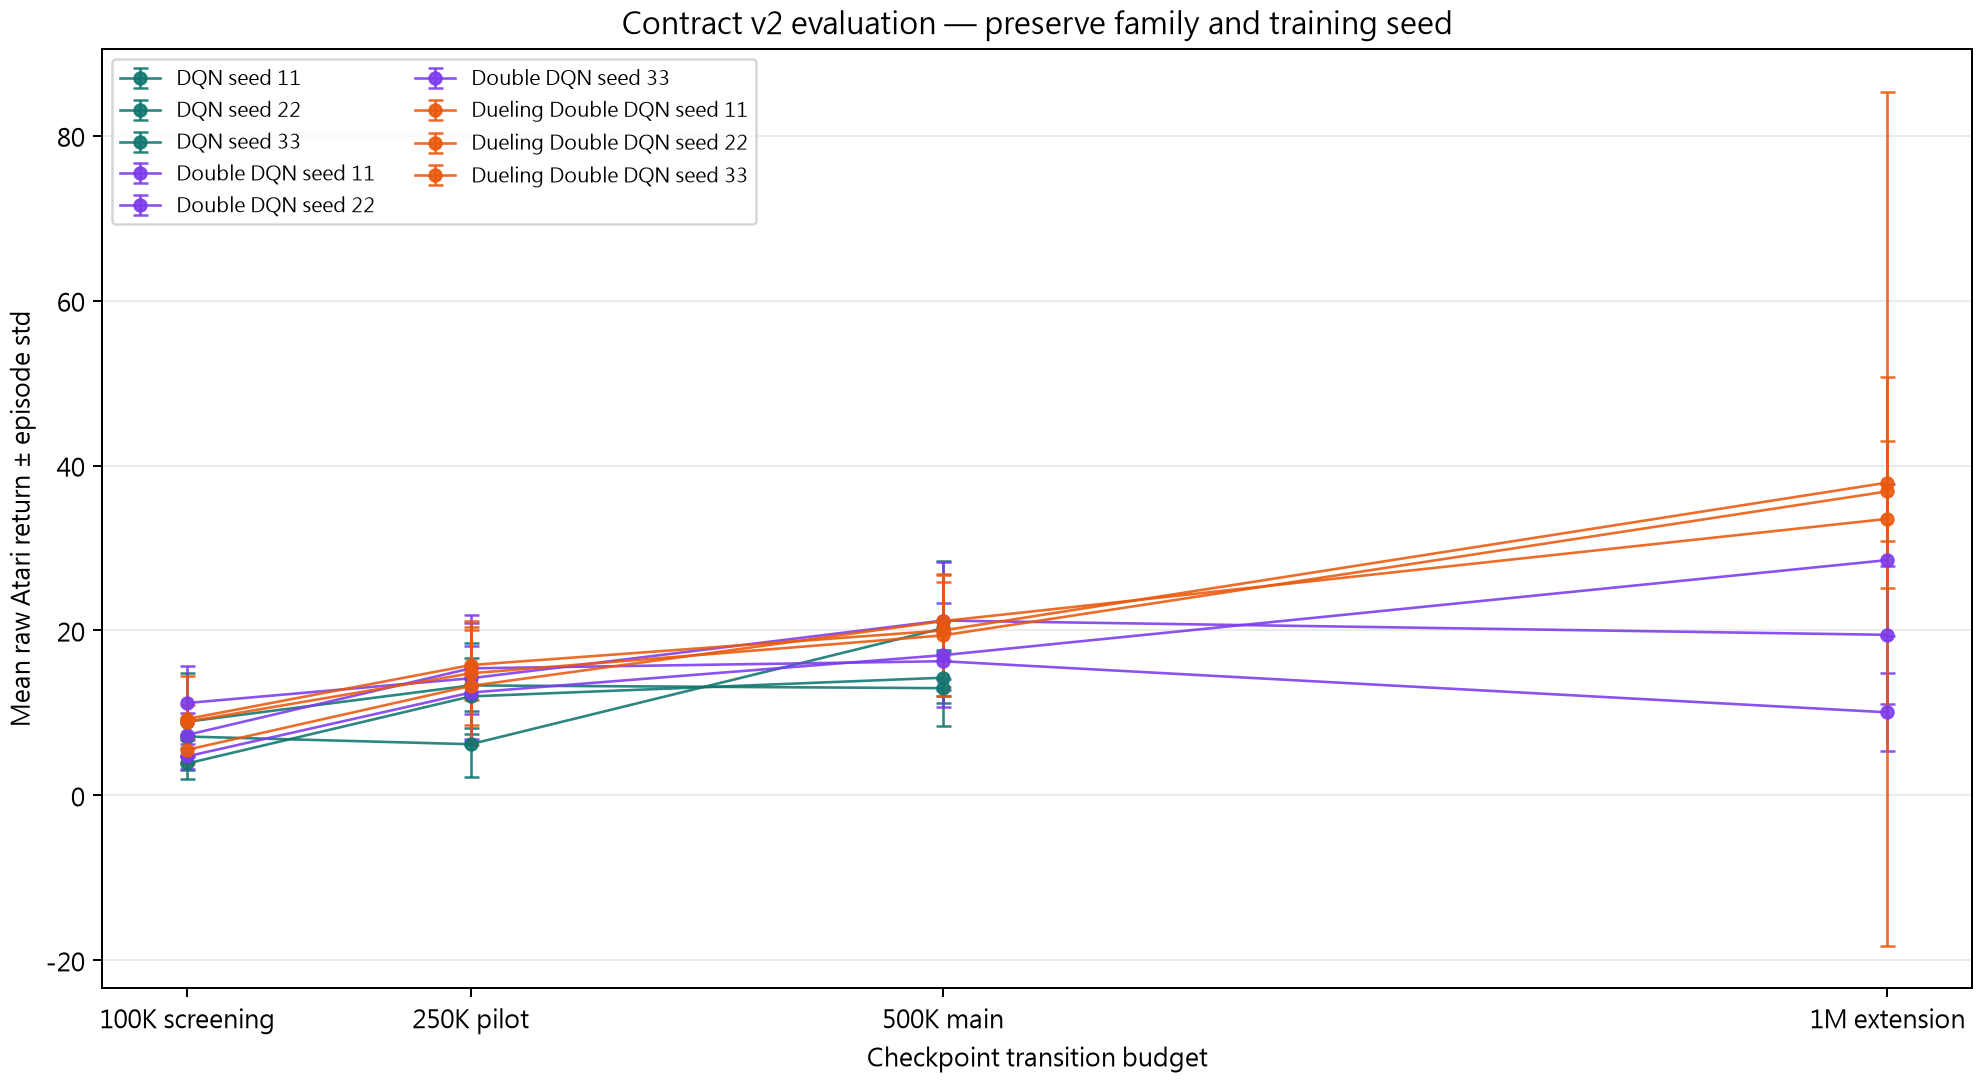
圖 2:每個點是某個 family、training seed 與 checkpoint 的 15 局平均;誤差棒是該 checkpoint 的 episode spread,不是 training-seed 之間的差異。來源:Day 20 evaluation artifact。

1M:比較方向變一致,但仍然不是最後模型
因為 500K 的結果重疊且 seed 方向不一致,Day 20 沒有把三個 family 都宣稱為 winner,而是把 Double DQN 與 Dueling Double DQN 這兩個 top-2 候選延長到 1M。它們從 500K checkpoint 接續、使用相同的 resume 與 replay warm-up 規則。
| Family | seed 11 | seed 22 | seed 33 | 三個 seed 平均 |
|---|---|---|---|---|
| Double DQN | 28.533 | 10.067 | 19.467 | 19.356 |
| Dueling Double DQN | 33.533 | 36.867 | 37.933 | 36.111 |
這次 paired differences 變成:
seed 11: +5.000
seed 22: +26.800
seed 33: +18.467
三個方向都支持 Dueling Double DQN,所以 Day 20 的工程決策是把它選為 final-training family。這個名稱很重要:它代表接下來應該把長訓練計算集中在哪個 family,不代表已經找到一個不需要再檢查的 final model。
品質之外的代價:Dueling 並不是免費的
Day 20 的 family selection 也保留了實際成本。500K formal runs 的平均值如下:
| Family | Parameters | Mean SPS | Mean wall-clock |
|---|---|---|---|
| DQN | 1.69M | 350.1 | 714.7 s |
| Double DQN | 1.69M | 345.6 | 723.5 s |
| Dueling Double DQN | 3.29M | 219.5 | 1,146.3 s |
Dueling 的 quality evidence 在 1M extension 變得更一致,但它的模型參數接近兩倍、訓練吞吐較低、wall-clock 較長。這不是「又快又強」,而是一次帶有計算成本的 quality-versus-cost trade-off。
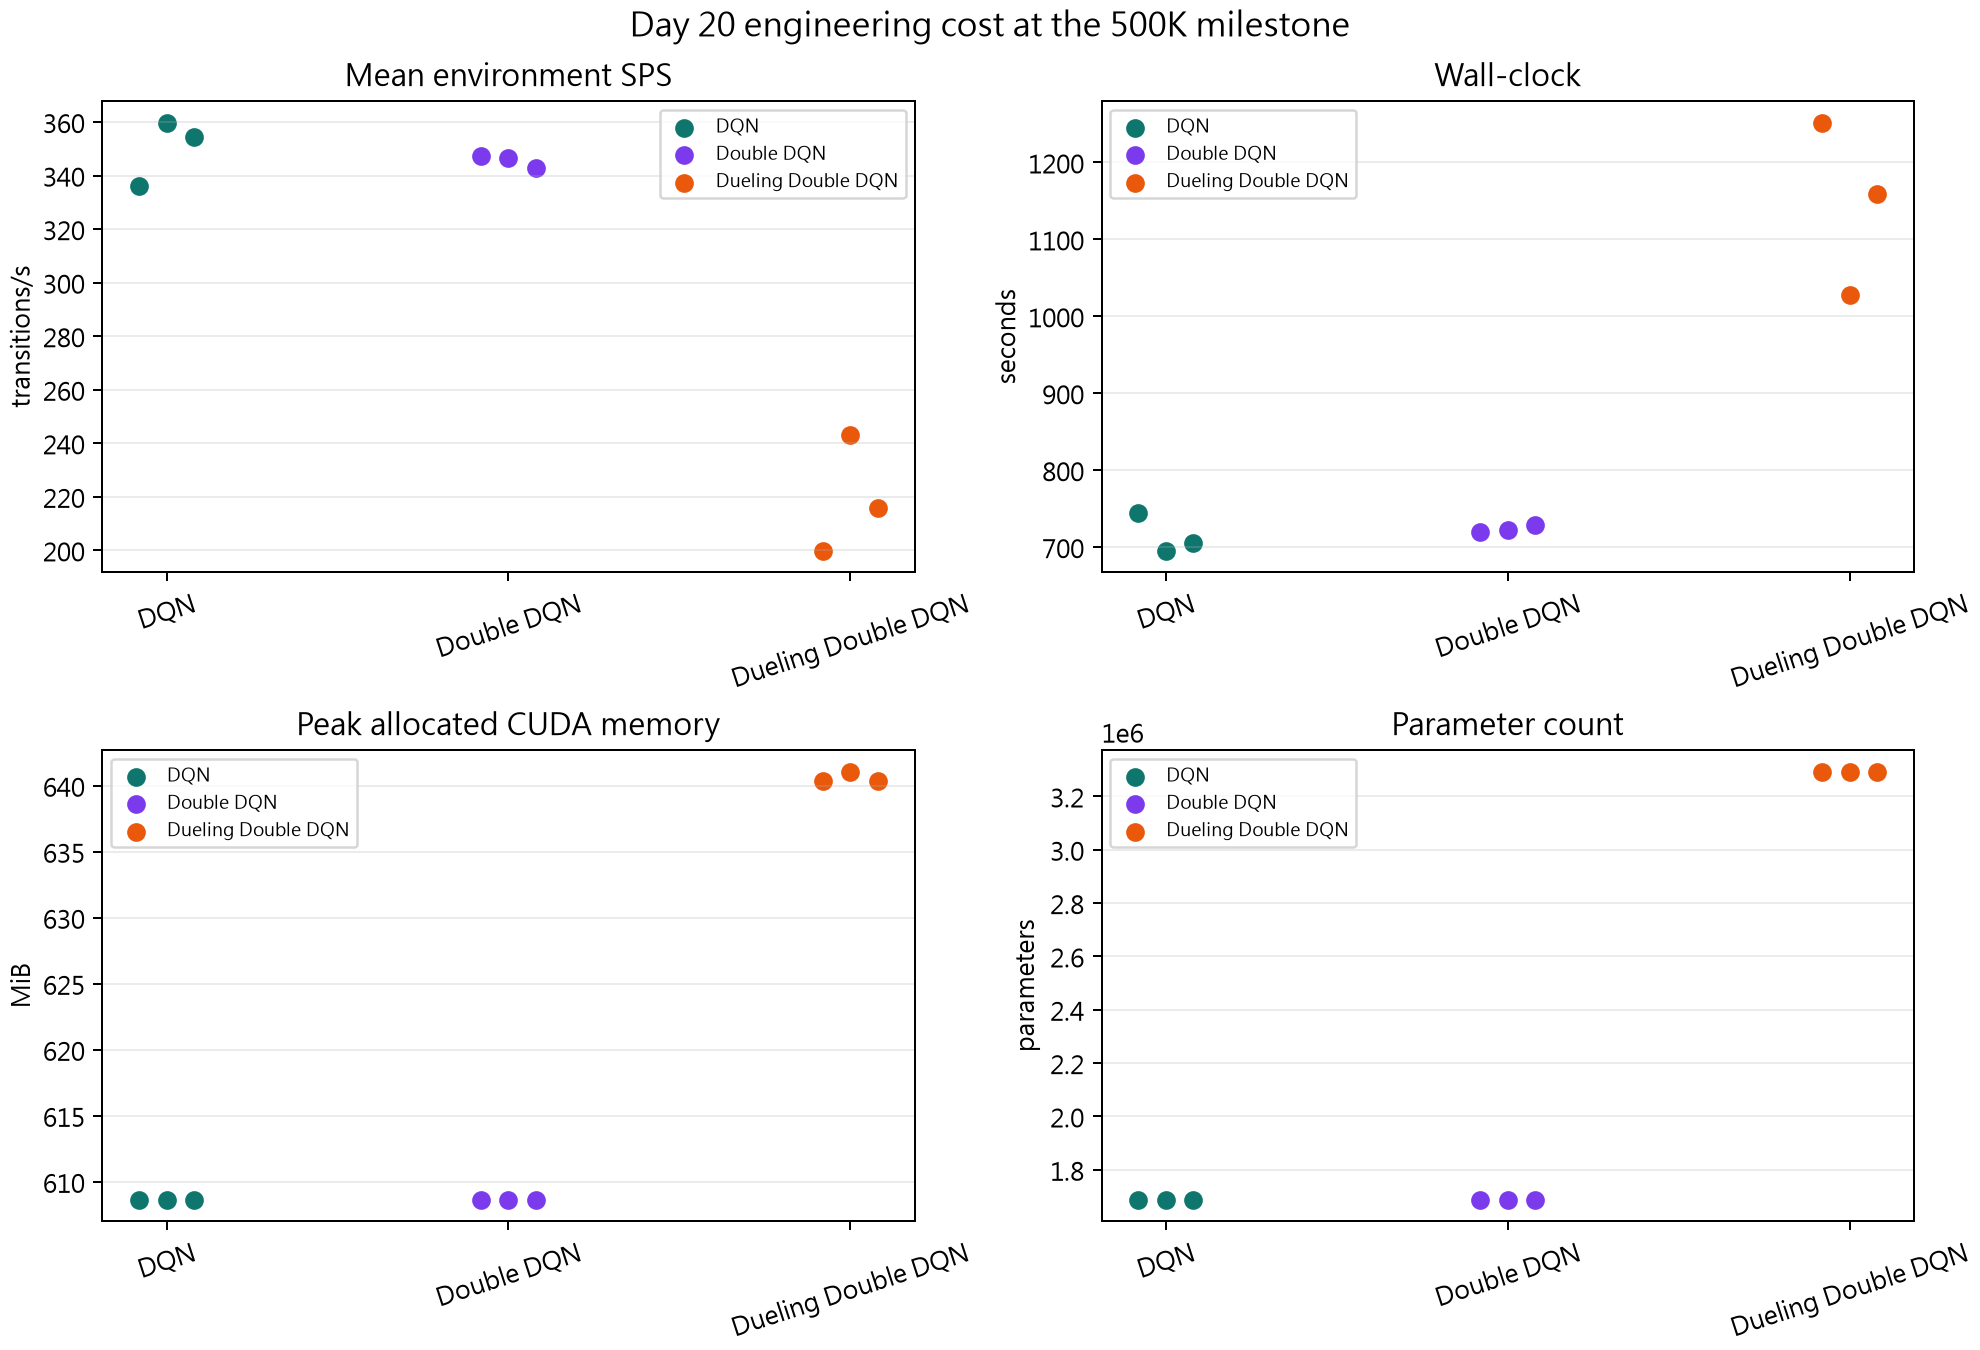
圖 3:這張圖描述 engineering cost,不是模型品質排名;來源:Day 20 runtime-cost artifact。

而且這個 comparison 不是等參數量的 architecture ablation。Dueling 同時改變了 network representation 與 model capacity,因此可以說「這個實際 family 在目前 protocol 下值得繼續」,不能把所有提升嚴格歸因於 Value/Advantage split 本身。
Day 21:長訓練也必須保留 model selection 邊界
選出 Dueling Double DQN 之後,Day 21 沒有直接沿用 Day 20 最好的那個 seed,而是使用三個新的 training seeds:1011 / 2022 / 3033。到 1M 時,三個 seed 的 fixed evaluation 平均分是 34.000、34.867 與 33.133;這表示換一組新的訓練開局後,方法仍然能重新學起來,而不是只靠某一次 lucky initialization。
計算資源有限,因此候選逐階段縮小。1011 與 2022 繼續到 2.5M:
| Training seed | 1M | 2.5M |
|---|---|---|
| 1011 | 34.000 | 42.600 |
| 2022 | 34.867 | 51.400 |
seed 2022 再繼續到 5M 後,固定 evaluation 是 49.933。這不表示模型必然退步,因為每次只有 15 局且 episode 具有波動;比較精確的說法是:目前沒有證據支持多訓練到 5M 就會比 2.5M 更好。 因此最後保留的是 2.5M checkpoint,而不是因為步數較大的 5M。
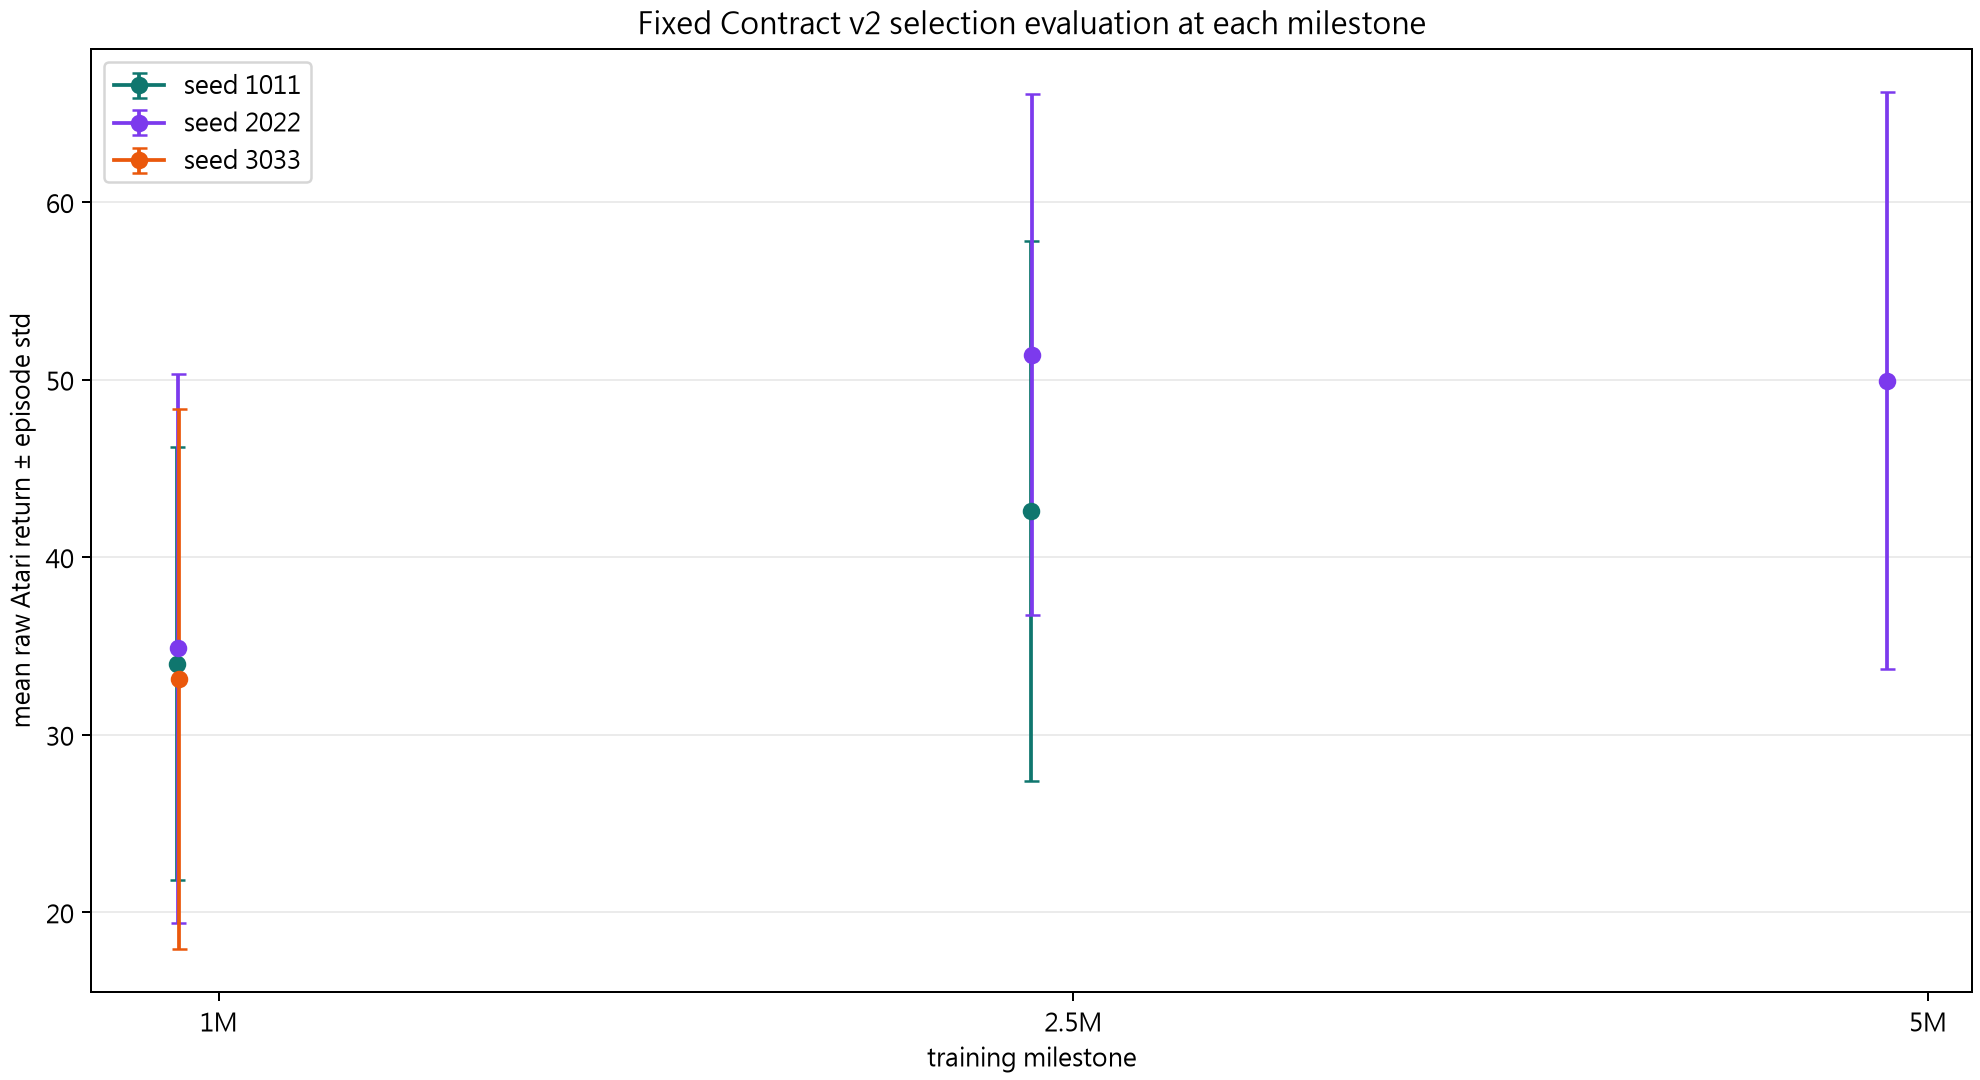
圖 4:停止點由固定 evaluation 的模型表現決定,而不是由預定的最大步數自動決定;來源:Day 21 milestone artifact。

但 51.400 仍然不能直接叫做 final performance。這批 evaluation 已經被用來比較 1M、2.5M、決定誰進入 5M,以及挑選 checkpoint;它是 model-selection evidence,不是 untouched test。模型 freeze 之後,才使用沒有參與挑選的新 holdout seeds,結果平均是 30.933、中位數是 32.000。
| 評估角色 | 平均 | 中位數 | 能支持的說法 |
|---|---|---|---|
| Model-selection evaluation | 51.400 | 51.000 | 2.5M 在已知選擇條件下勝過 5M |
| Final holdout | 30.933 | 32.000 | 新測試條件下的另一個、較低的觀察結果 |
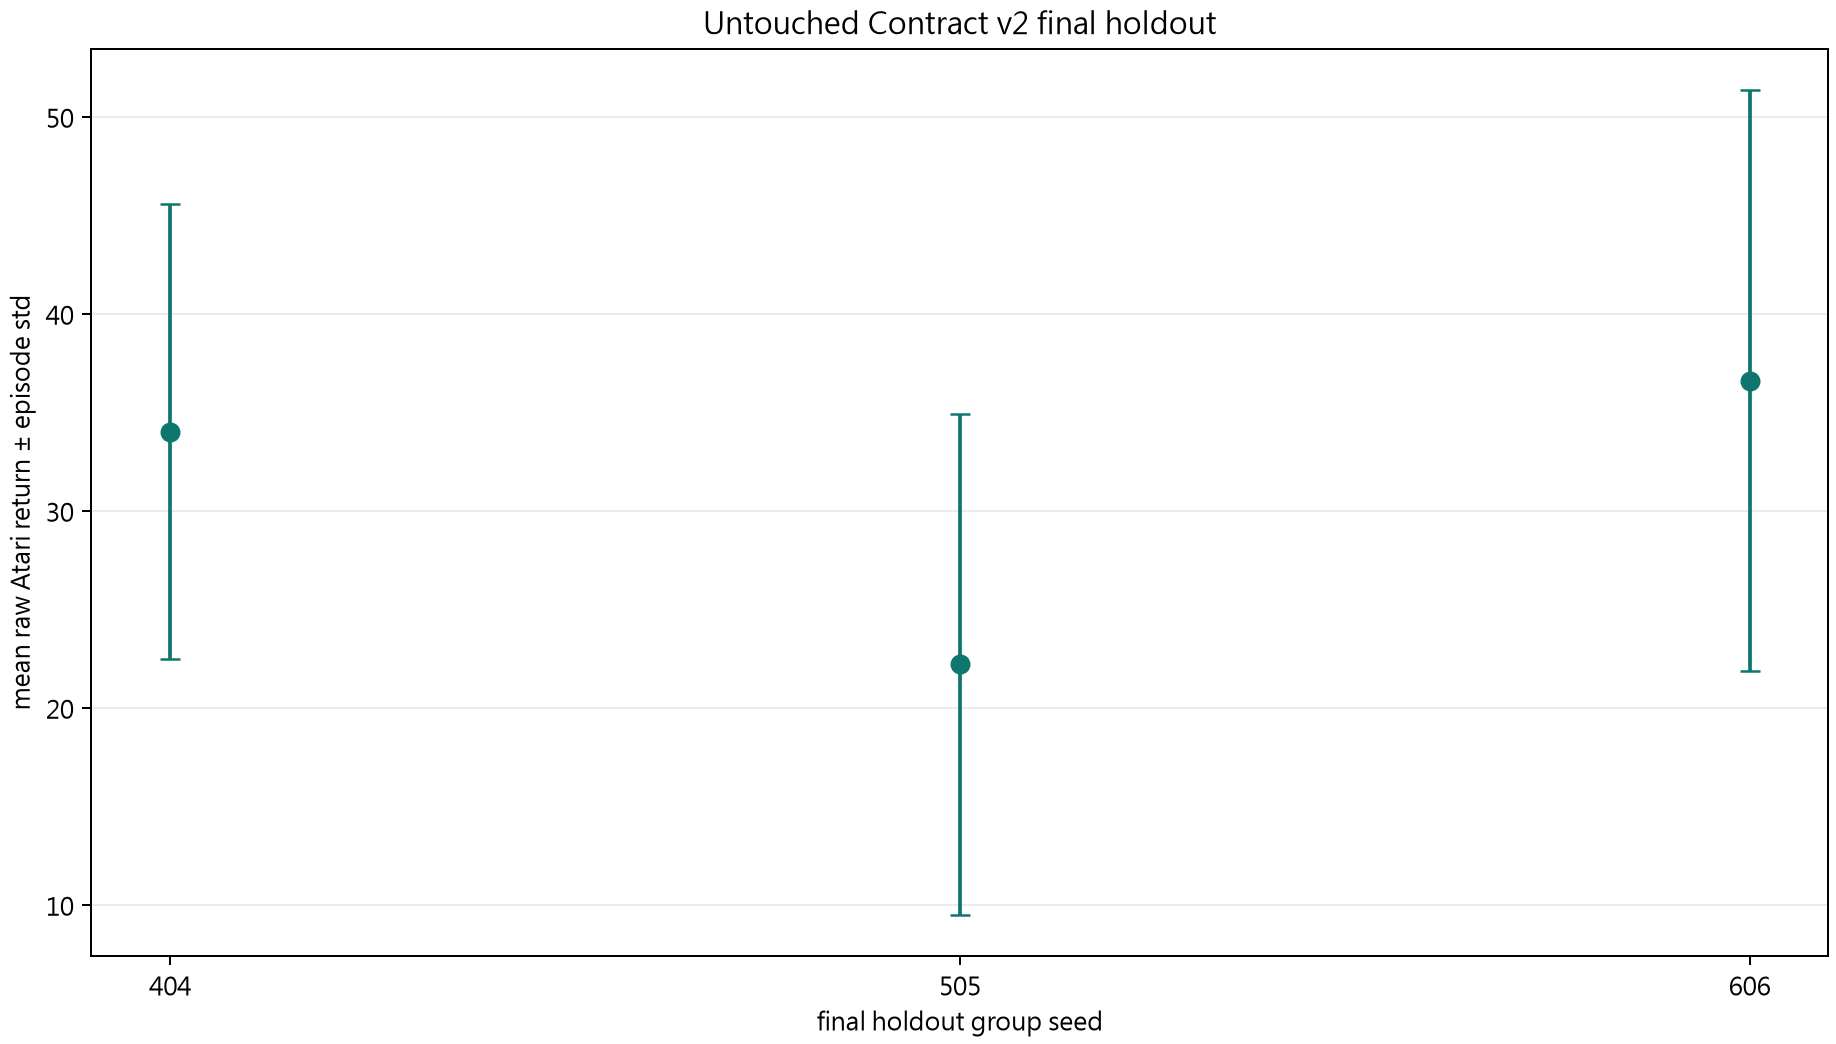
圖 5:holdout 是在模型 freeze 後才開啟的另一組 15 局測試;來源:Day 21 holdout artifact。

這個落差不能直接被寫成「模型已經 overfit」,因為 holdout 仍然只有 15 局,而 Breakout 的 episode return 會受到遊戲隨機性影響。它能支持的結論比較窄:用來選模型的 51.4,不等於模型面對新測試時的普遍平均能力。
這組證據最後允許我們說什麼
Days 16–21 留下的不是一個脫離條件的「最佳 DQN」,而是一條有邊界的工程決策鏈:
- 向量化讓 training pipeline 在 100K 實驗中找到 N=2 的 1.60× throughput trade-off,但 throughput 沒有自動轉成較高 return。
- Double DQN 在 500K 的三個 paired seeds 都高於 DQN;加入 Dueling 後,Dueling 在 500K 平均領先卻被 seed 33 反超,延長到 1M 才在三個 paired seeds 都高於 Double。
- Dueling Double DQN 因而成為後續長訓練的 family,但它有更大的模型與更高的 runtime cost,且這不是等參數量的 causal ablation。
- Day 21 的新 seeds 顯示方法可以重新學起來;在 seed 2022 上,2.5M 的 model-selection score 高於 5M,但新的 holdout 平均只有 30.933。
因此可以說:在固定的 Contract v2、CUDA backend、staged transition budgets、training seed scope 與 15-episode evaluation protocol 下,Dueling Double DQN 是最值得進入後續長訓練的 family,2.5M 是當時保留的 checkpoint。
不能說的是:Dueling 在所有環境與 seeds 都必然更強、Value/Advantage split 已被隔離證明是唯一原因、2.5M 的 51.4 是泛化能力,或這三個 training seeds 已經足以提供普遍性的統計保證。現有 evidence 有 paired seed differences、seed spread、episode mean/median/std 與 holdout observation;沒有跨大量 training seeds 的穩健性結論,也沒有把 evaluation episodes 當成 training replicates 的理由。
這正是公平比較的價值:它不保證結果一定漂亮,卻能把「改了什麼、付出多少、在哪些條件下看到什麼、還不知道什麼」一起留下來。當模型下一步要進入 ONNX 與其他 runtime 時,這些邊界會比一個沒有 provenance 的最高分更重要。