Article · Writing
從 PyTorch 到 ONNX:正確 Benchmark 與最佳化 RL 推論
把 Breakout DQN 變成可攜式推論 artifact,並用 parity、batch=1 latency 與多局 score evidence 判斷最佳化是否真的值得採用。
Evidence trail
Provenance
這篇內容的 canonical URL 是 /writing/onnx-inference-engineering/,發布日期為 2026年9月22日。
相關 Project 證據與實作:https://github.com/Tommyweige/breakout-rl-engineering
這篇內容也保留在其 Series 關係中;正文不需要依賴前一篇才能閱讀。
相容的歷史路徑:/posts/onnx-inference-engineering/
文章目錄
把 PyTorch checkpoint 轉成 .onnx,只代表多了一個模型檔案;它不代表這個模型在另一個 runtime 裡仍然是同一個 Agent,更不代表你量到的毫秒數可以拿來做公平比較。
這個差別在 Breakout 特別明顯:Agent 每次會替四個 action 算出 Q-value,再選分數最高的 action。只要一次浮點誤差改變了選擇,下一個畫面就可能不同,後面的互動軌跡也會分岔。因此,這段工程工作的核心問題不是「怎麼把模型跑得更快」,而是:如何把訓練好的 policy 變成可攜式的推論 artifact,同時保住行為有效性與 benchmark 的可信度?
本文把 Original Breakout Ironman Series 的 Days 22–26 重新整理成一條驗證路徑:先固定 export contract,再確認 PyTorch 與 ONNX Runtime 的決策一致,接著量真正的 batch-one 使用情境,最後才比較 FP16 與 TensorRT。這篇文章的結果只適用於這個模型、這組 runtime、測試條件與可辨識的硬體資訊;它不是對所有 GPU 或所有工作負載的保證。
.onnx 檔案先要說清楚自己接受什麼
模型要離開 PyTorch,第一個風險不是速度,而是輸入輸出在轉換時悄悄改變。這裡的 policy 接受一筆 stacked observation:四張 84 × 84 的畫面,並回傳四個 action 對應的 Q-value。這組形狀與輸出意義就是 export contract;它把「模型本身負責什麼」和「遊戲環境負責什麼」分開。
ONNX(Open Neural Network Exchange)是用來描述神經網路的交換格式;ONNX Runtime(ORT)則是實際讀取這份格式並執行推論的 runtime。.onnx 通過結構檢查,只能說檔案的 graph 合法,不能說它算出的 Q-value 或選出的 action 仍然符合 PyTorch。這也是為什麼轉換後不能直接跳到效能表格:先要驗證行為。
原始 Day 22 的 export 結果保留了這個邊界:模型能以相同的四張畫面作為輸入,輸出仍然是四個 Q-value;瀏覽器、WebGPU 與完整產品流程則留給後續的 browser-deployment Article。這樣的切分很重要,因為「模型可以被另一個 runtime 載入」和「整個環境已經完成跨平台 parity」是兩個不同的命題。
怎麼知道換了 runtime,還是同一個 Agent?
最小的可重現檢查,是把完全相同的 60 個遊戲狀態交給 PyTorch、ORT CPU 與 ORT CUDA,逐一比較 Q-value 與 greedy action。這裡的 action 一致率比單看浮點數更接近 Agent 的行為:Q-value 可以有很小的差異,只要最高分的 action 沒有改變,policy 在這個輸入上的決策就沒有改變。
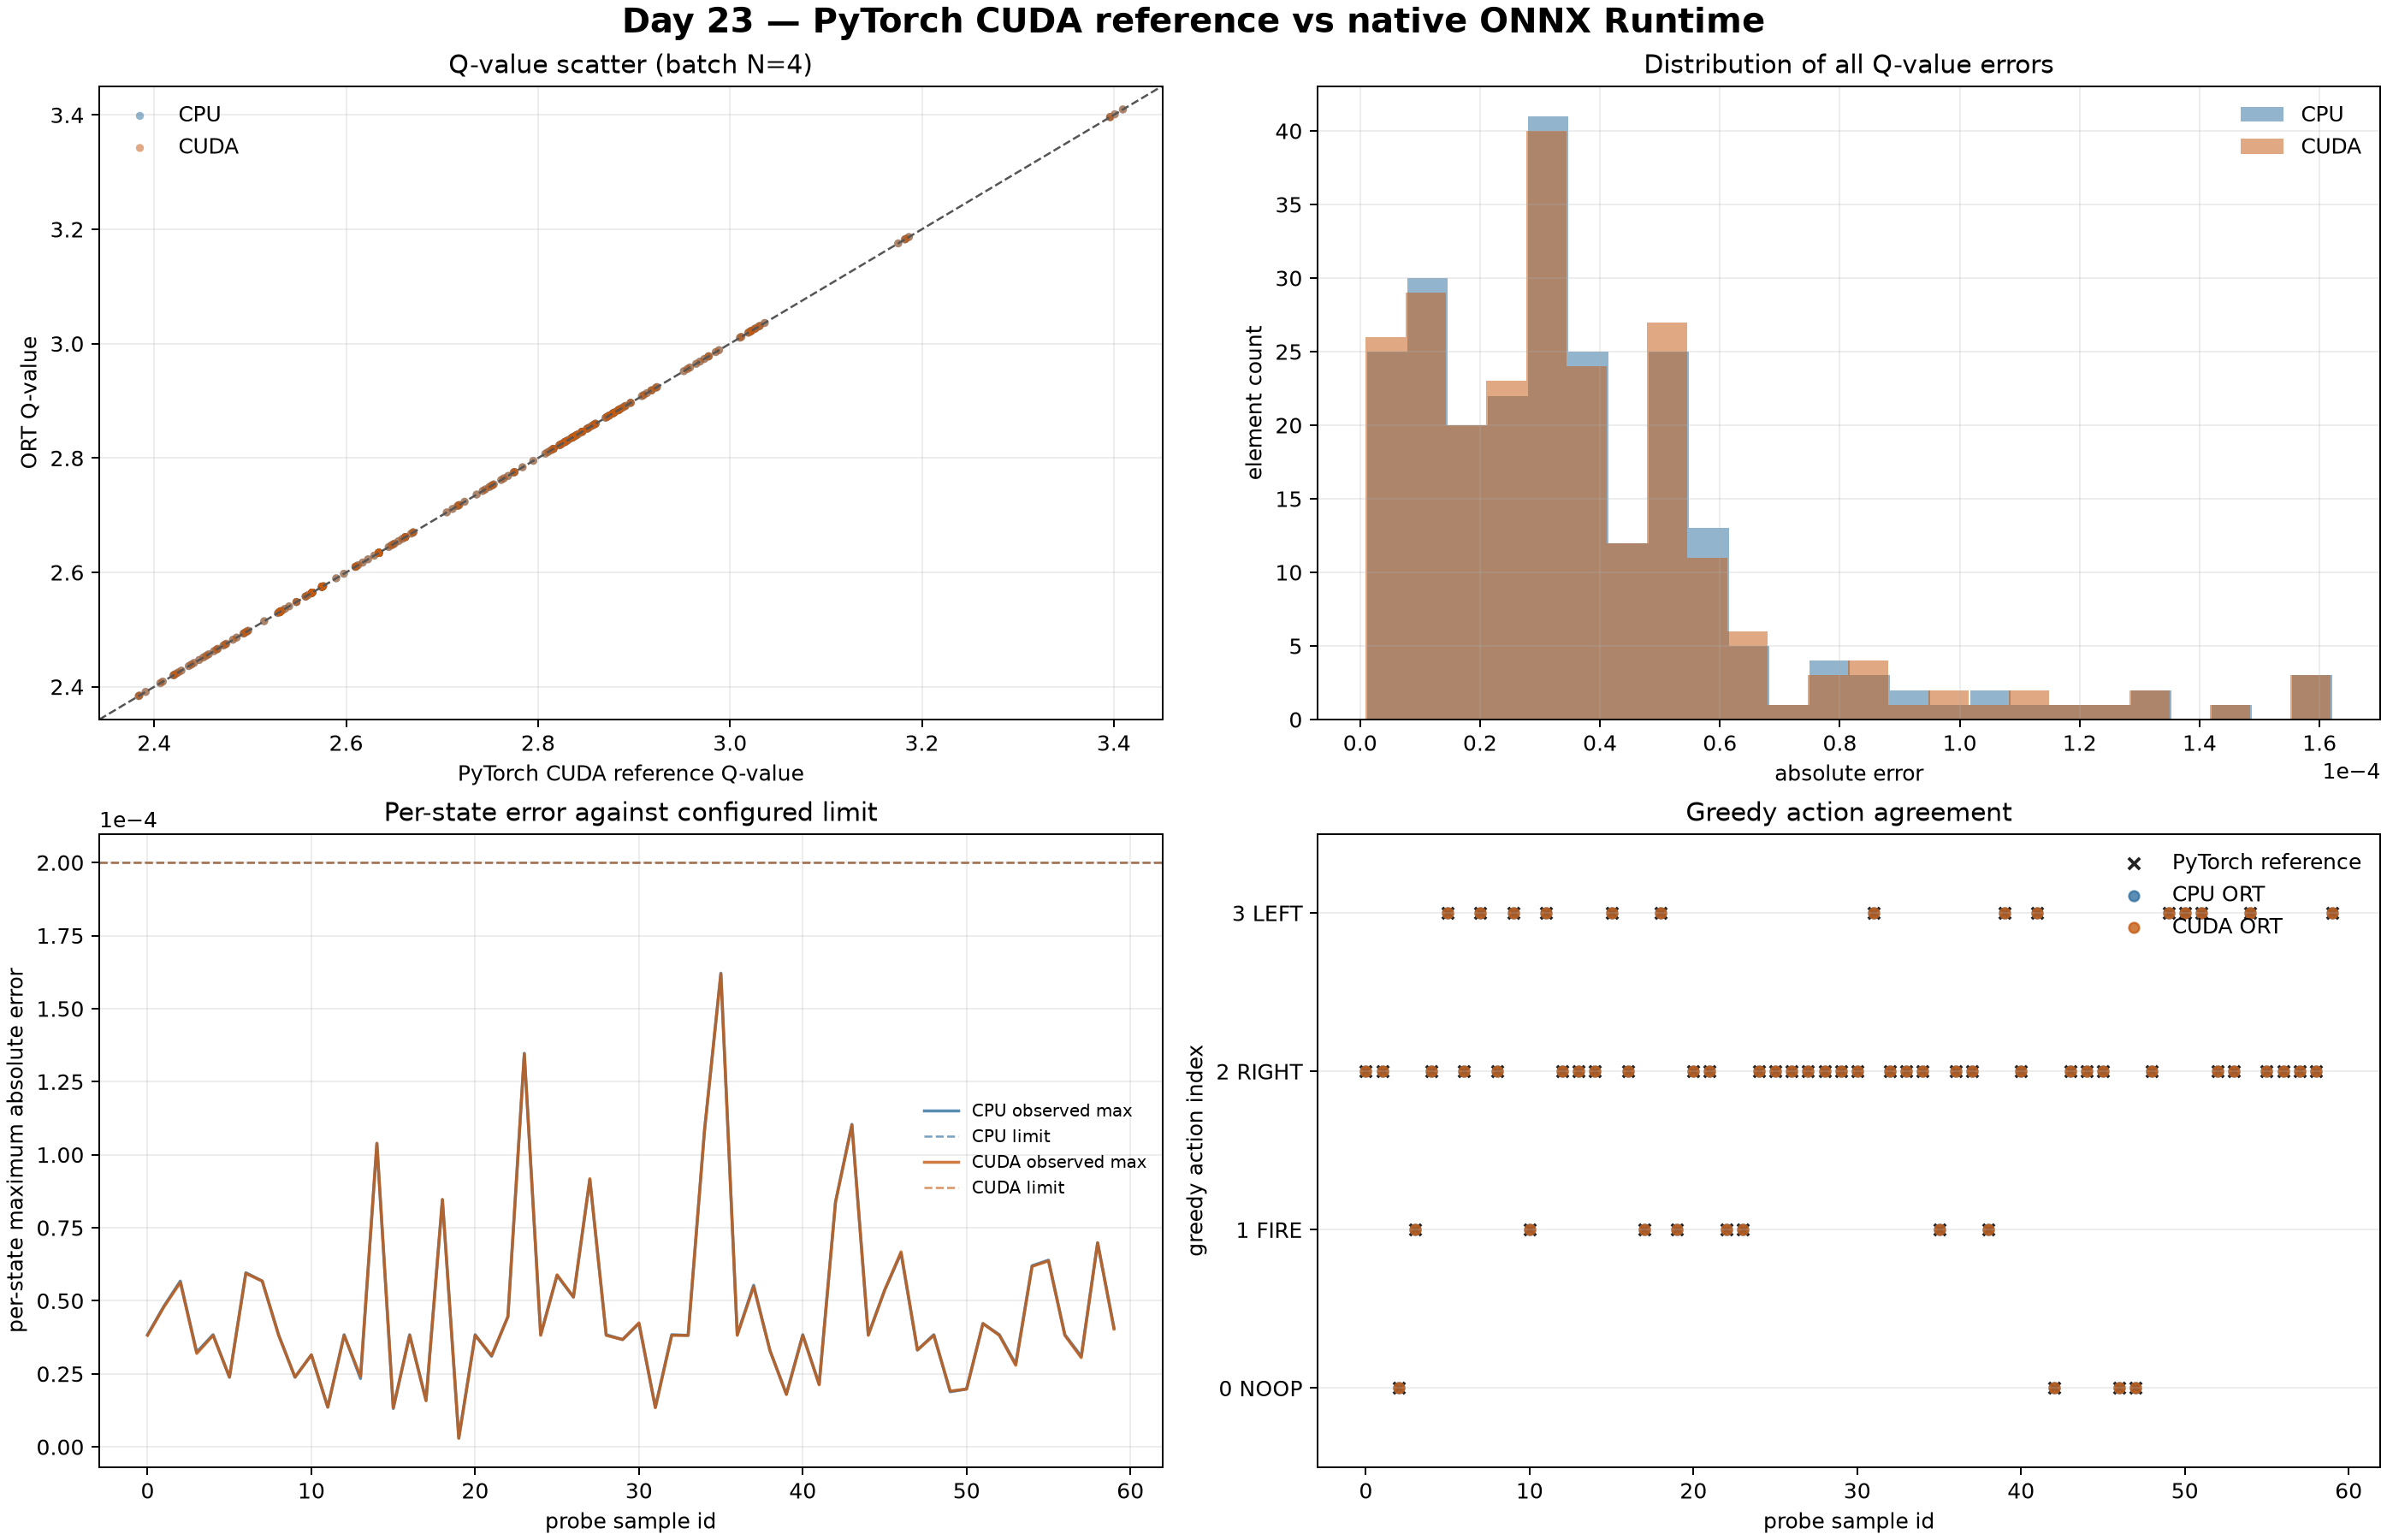
圖中的左上圖把 ORT 的 Q-value 對到 PyTorch 參考值;右上圖呈現所有 Q-value 誤差;左下圖則把每個狀態的最大誤差和設定的限制放在一起,右下圖直接檢查 greedy action。這批 60 個固定狀態的最大差異約為 0.000162,三個 runtime 的 action 一致率都是 100%。另外,ORT CUDA 的 execution provider 檢查確認 16 個運算節點都由 CUDA 執行,沒有把要求 GPU 的測試悄悄退回 CPU。
這些結果支持一個有範圍的結論:在這批固定輸入上,ONNX Runtime CPU 與 CUDA 都保留了 PyTorch 的決策。它們不支持「所有輸入、所有硬體都完全相同」的宣稱,也不等於瀏覽器中的 WASM 或 WebGPU 已經驗證完成。
延遲要量的是哪一段?
如果目標是即時 Breakout,一次只會根據當下的一個 stacked observation 做決策;把大量 observation 湊成 batch 可能得到漂亮的吞吐量,卻不一定回答產品真正遇到的問題。因此 Day 24 的主要 benchmark 固定為 batch=1,並把「只呼叫模型」和「完成一次 policy decision」分開。
正式測量前先做 25 次 warm-up,讓第一次載入、記憶體配置或 runtime 初始化不混進結果;接著記錄 100 次正式樣本。GPU 的工作可能是非同步提交的,所以測量前後都要 synchronization,確保計時包含模型真的完成計算的時間,而不是只量到 Python 把工作交出去的瞬間。
這樣得到的不是一個「最快的一次」,而是一組 latency distribution。P50 是排序後位於中間的延遲,可用來理解一般情況;P95 則描述較慢尾端,對互動系統更有意義。
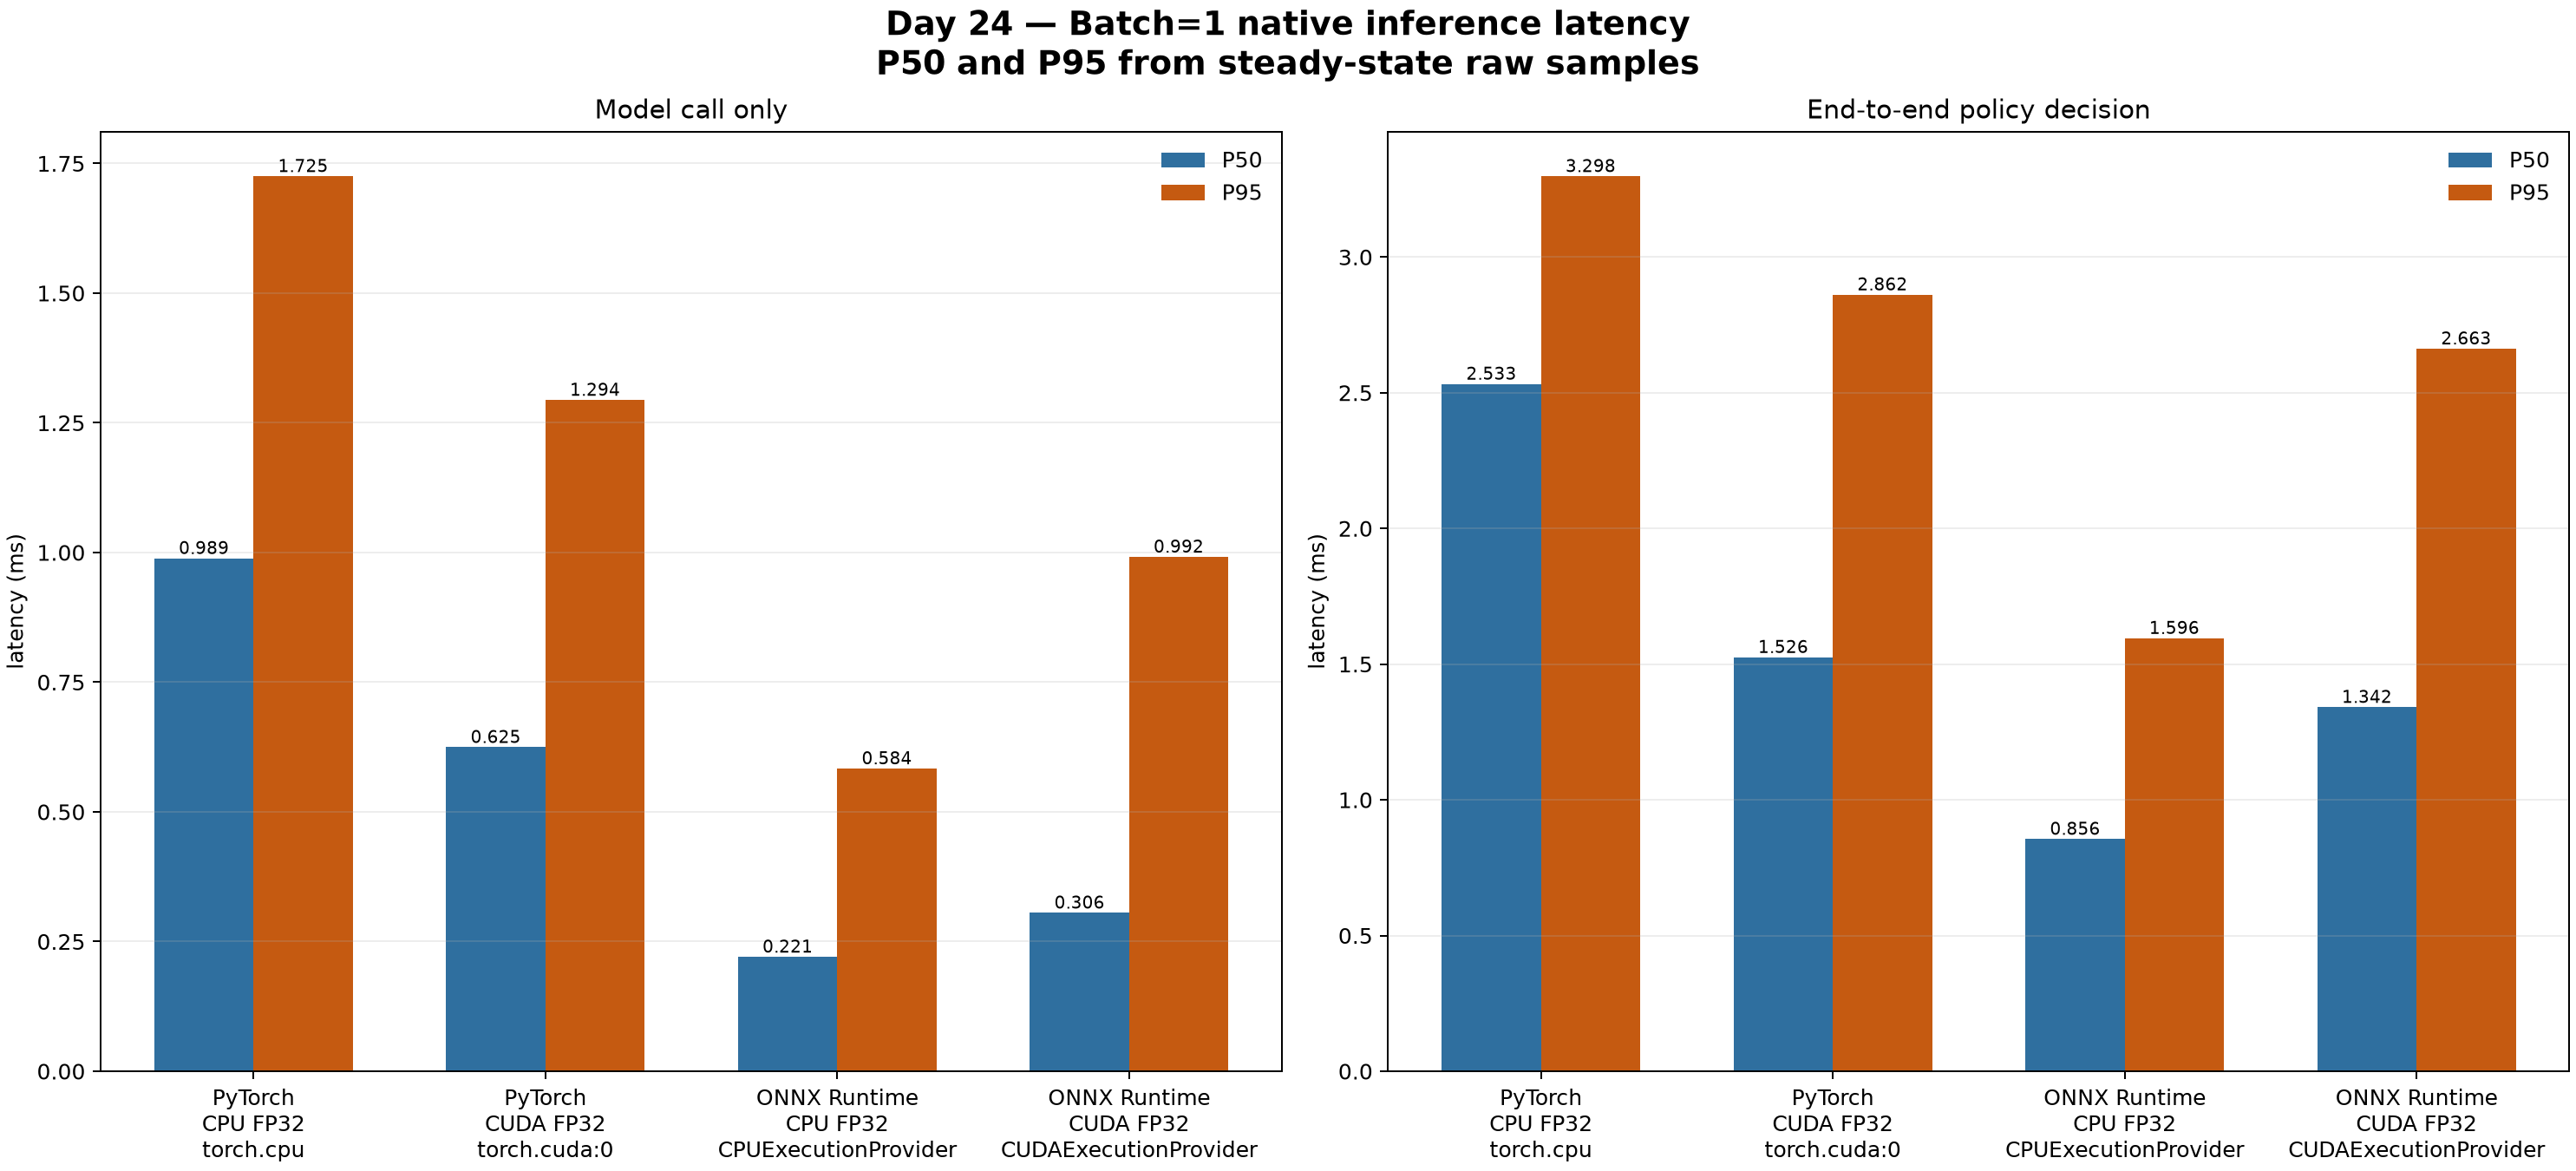
這張圖的左右兩側分別是 model call only 與 end-to-end policy decision;橫軸標示 runtime 與實際 provider,縱軸是毫秒。正式 v2 run 的完整決策結果如下:
| 執行方式 | P50 | P95 |
|---|---|---|
| PyTorch CPU | 2.533 ms | 3.298 ms |
| PyTorch CUDA | 1.526 ms | 2.862 ms |
ORT CPU(CPUExecutionProvider) | 0.856 ms | 1.596 ms |
ORT CUDA(CUDAExecutionProvider) | 1.342 ms | 2.663 ms |
在這個小模型、batch=1 的工作負載裡,ORT CPU 反而比 ORT CUDA 快;這不代表 CPU 永遠比 GPU 快,而是資料搬移、GPU 啟動與等待成本在短推論上可能比神經網路本身更顯眼。benchmark 還比較了「模型呼叫」與「完整決策」,所以不能把其中一欄誤讀成整個遊戲的 frame time。
可辨識的硬體資訊在 Day 26 明確記錄為 RTX 4060 Laptop GPU;原始報告並沒有提供一份足以泛化到所有 CPU、驅動與記憶體組合的完整 machine inventory。因此上表的毫秒數應該被理解成這組實驗條件下的觀測,而不是硬體無關的規格。
FP16 讓模型變小,為什麼仍然不採用?
FP32 用 32 位元保存浮點數,FP16 用 16 位元。較低精度通常能減少模型大小,但「檔案比較小」與「一次決策比較快」不是同一件事;更重要的是,Q-value 接近時,數值取捨可能讓最高分 action 改變。
這次把同樣的 60 個狀態交給 FP32 與 FP16,兩種路徑都看到 4 個 action 改變,一致率是 93.33%。模型大小則從 13,175,034 bytes 降到 6,590,582 bytes,約少 49.98%。但在同一輪 batch=1 測試裡,FP16 沒有換到速度:PyTorch 的 P95 從 8.978 ms 變成 10.690 ms,ORT 的 P95 從 5.541 ms 變成 6.727 ms。
這組絕對毫秒數不拿來取代 Day 24 的正式基準,因為兩天的系統狀態不同;這裡看的是同一輪 FP32 與 FP16 的相對方向。結果支持的是「這個 Breakout 工作負載目前不採用 FP16」,不是「FP16 對所有模型都不好」。如果主要瓶頸是下載大小或記憶體,較小的模型仍可能值得考慮;但本次最想要的速度收益沒有出現,還伴隨 action parity 風險。
TensorRT 的速度收益,如何才算真的成立?
TensorRT 可以把它理解成針對 NVIDIA GPU 建立的專用執行版本;它不會重新訓練 Agent,只是在另一個 runtime 裡執行同一份 policy。這代表它必須同時通過兩種檢查:固定輸入上的模型 parity,以及多局互動中的整體能力。
在 RTX 4060 Laptop GPU、batch=1 的測試中,TensorRT FP32 的 P50/P95 是 0.634 / 0.761 ms;ORT FP32 是 0.667 / 1.110 ms。因此 P95 從約 1.110 ms 降到 0.761 ms,改善約 31%。但這個速度數字只有在 provider、同步方式、樣本方法與工作負載都被說清楚時才有意義。
速度通過後,60 個固定狀態的 TensorRT FP32 action 一致率仍是 100%;TensorRT FP16 則是 93.33%。固定狀態很適合抓轉換錯誤,卻不能單獨決定 RL runtime 是否值得採用,因為 action 一旦不同,後面的畫面就會跟著不同。完整遊戲不能要求每一步 trace 都逐字複製,應該把共用起點與多局結果納入判斷。
為什麼最後要看 30 局,而不是只看 60 張畫面?
Day 26 固定 30 個 episode seeds,讓 PyTorch FP32、ORT FP32、TensorRT FP32 與 TensorRT FP16 共用相同的起點。每個 runtime 都跑同一組 seeds,再比較每局 raw Atari score 的分布,以及同一個 seed 配對後的分數差。這樣才能把「某一步路線分岔」和「整體得分能力退化」分開。
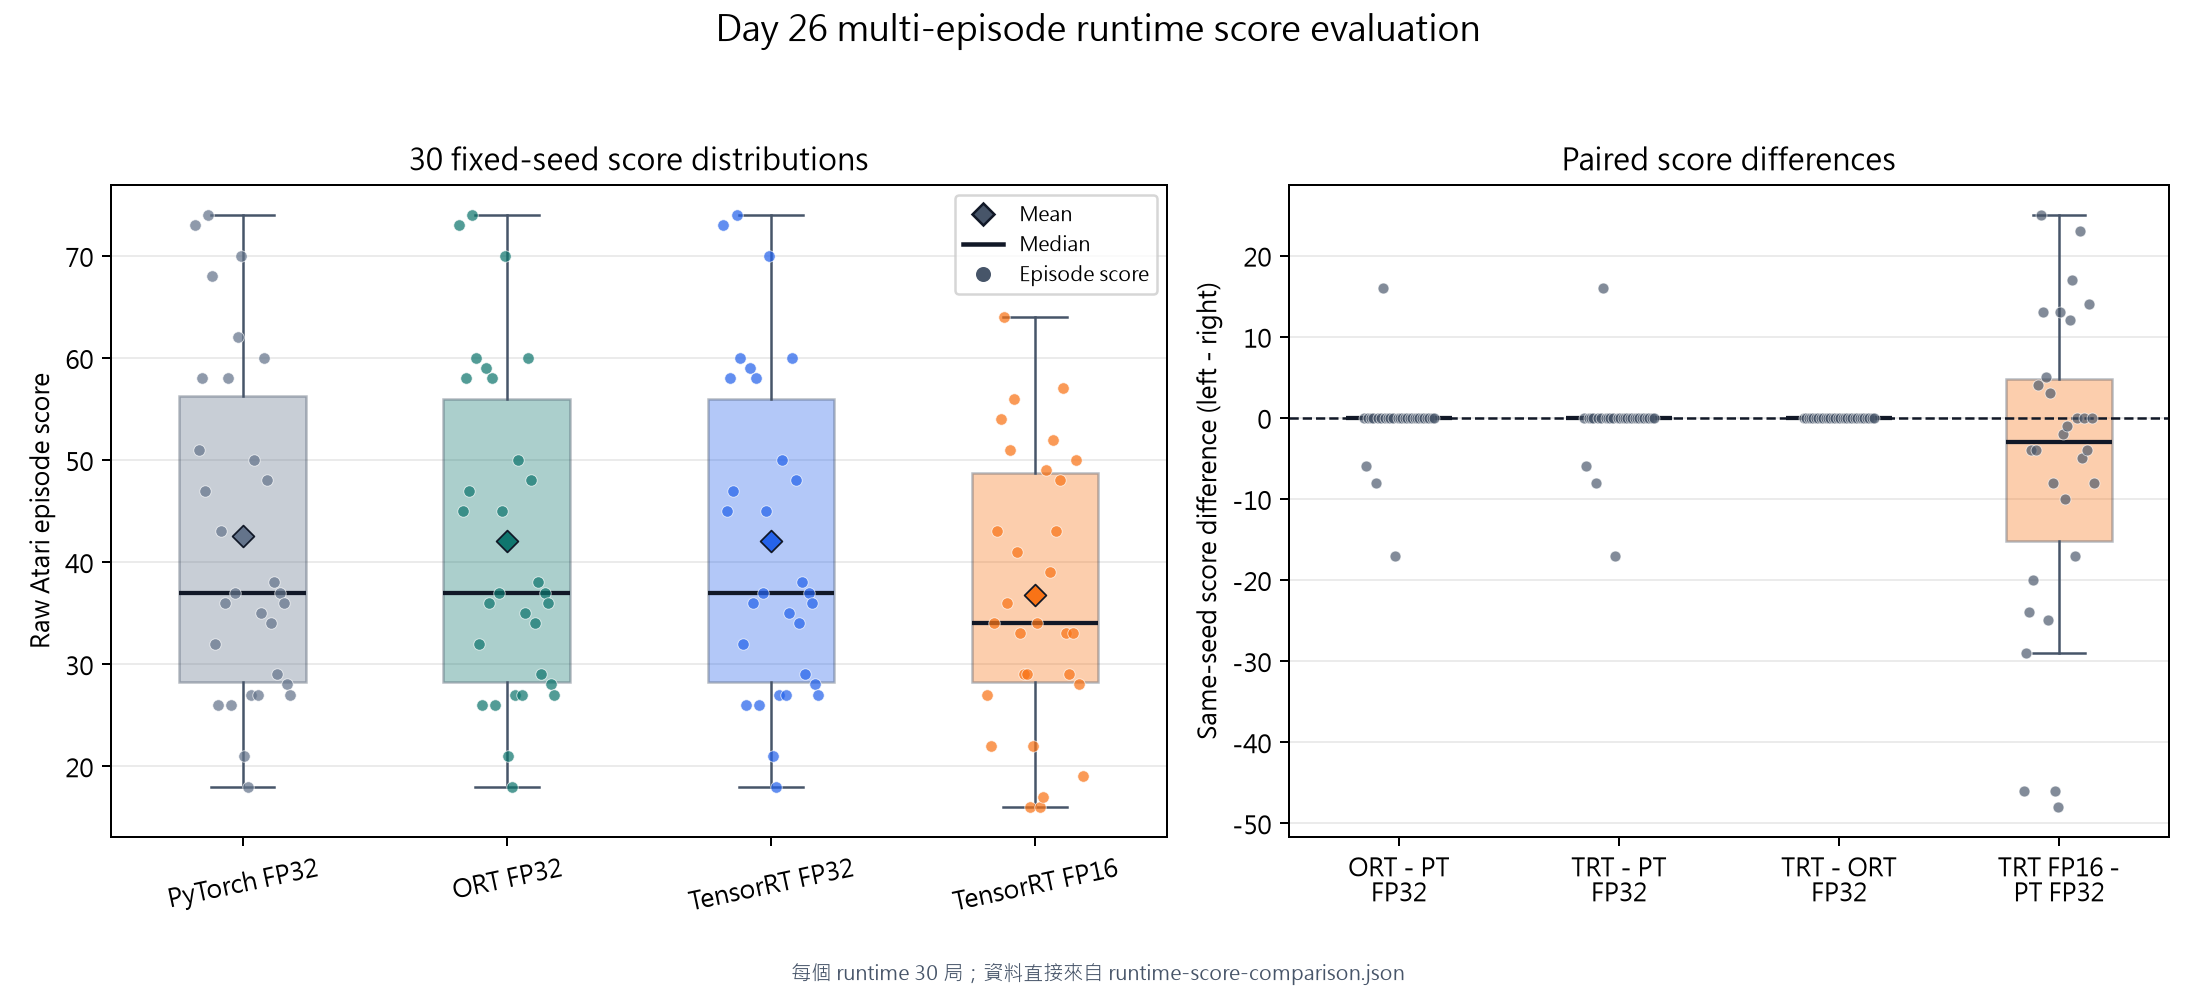
左圖的每個點是一局 raw Atari score,箱型圖顯示分布,菱形是平均值;右圖把同一 seed 的分數相減,讓不同 runtime 直接配對。TensorRT FP32 與 ORT FP32 的 30 個 paired differences 全部是 0,兩者的每局 score 也完全一致。TensorRT FP32 對 PyTorch FP32 的平均差是 -0.50,但 ORT FP32 對 PyTorch 也是 -0.50,所以這輪觀察到的差異不是 TensorRT FP32 額外造成的退化。
| 執行方式 | 局數 | 平均 | 中位數 | P10–P90 | 最低–最高 |
|---|---|---|---|---|---|
| PyTorch FP32 | 30 | 42.53 | 37 | 26.0–68.2 | 18–74 |
| ORT FP32 | 30 | 42.03 | 37 | 26.0–61.0 | 18–74 |
| TensorRT FP32 | 30 | 42.03 | 37 | 26.0–61.0 | 18–74 |
| TensorRT FP16 | 30 | 36.80 | 34 | 18.8–54.2 | 16–64 |
同 seed 的配對比較也保留了 bootstrap 95% CI:TensorRT FP32 − ORT FP32 的平均差是 0,區間是 [0, 0];TensorRT FP16 − PyTorch FP32 的平均差是 -5.73,區間是 [-12.83, 1.00]。這不能把 30 局變成所有未來情境的證明,但它提供了比單次分數或單一畫面更合適的 adoption evidence。
這條驗證路徑真正保證了什麼?
在這組模型、RTX 4060 Laptop GPU、provider、batch=1、同步方式與 30 個固定 seeds 的條件下,可以把結論分成三層:
- ONNX Runtime CPU 與 CUDA 在固定狀態測試中保留了 PyTorch 的 action decision,CUDA provider 也沒有被靜默替換成 CPU。
- FP16 雖然把模型縮小約一半,卻改變了部分固定狀態的 action,且在這輪 batch=1 測試中更慢,因此沒有被採用。
- TensorRT FP32 同時通過固定狀態 parity、多局 score distribution 與 paired comparison,並讓 P95 從 ORT FP32 的
1.110 ms降到0.761 ms;所以它在這個範圍內達到 native deployment-worthy,不是普遍性的最佳化保證。
這個結論也說明了正確順序:export → parity → benchmark → optimization → multi-episode evaluation。如果跳過 parity,速度可能是在量一個已經改變的模型;如果跳過 synchronization 或 warm-up,P50/P95 可能只是在量排程與初始化;如果只看固定畫面,則會把 RL 的互動性漏掉。
完整的 source corpus 仍保留 Original Breakout Ironman Series 的日誌順序;本篇是把 Days 22–26 依問題重新編排的 Core Series Article。可追溯的證據包括原始 Day 22–26 文章、Breakout environment contract、ONNX parity implementation、benchmark implementation、runtime score evaluation 與 TensorRT integration。下一篇會接著問:當 policy 與 environment 一起離開 Python、進入瀏覽器時,這些 parity 與效能邊界還能不能維持?