Article · Writing
從能跑到可信:建立、除錯與評估 DQN Agent
把一個能輸出 Q-value 的 DQN,接成可觀測、可除錯、可受控比較的 Breakout 訓練系統;並從 FIRE deadlock 看見評估協定為什麼也是模型的一部分。
Evidence trail
Provenance
這篇內容的 canonical URL 是 /writing/building-debugging-evaluating-dqn/,發布日期為 2026年9月22日。
相關 Project 證據與實作:https://github.com/Tommyweige/breakout-rl-engineering
這篇內容也保留在其 Series 關係中;正文不需要依賴前一篇才能閱讀。
文章目錄
一個 DQN(Deep Q-Network)在 Breakout 裡能跑起來,並不代表它已經值得相信。Original Breakout Ironman 的 Day 15 曾經得到一個看似漂亮的結果:固定 15 個起始條件下,DQN 的平均 raw reward 是 4.53,Random Policy 是 1.33。但 DQN 的平均一局長度竟然是 18,131 個 agent steps,其中 10/15 局不是正常結束,而是撞上 TimeLimit。
這不是「模型活得特別久」的簡單故事。它在掉命之後可能沒有重新按下 FIRE,於是停在等待發球的畫面,持續選出 RIGHT,直到時間上限把 episode 截斷。分數看起來變好,卻同時暴露了環境規則與評估方法的漏洞。
這篇 Article 以 Original Breakout Ironman Days 7–15 為來源,回答一個比「哪組參數分數最高」更重要的問題:怎麼把一個能計算 Q-value 的 DQN,接成一套可測試、可除錯、可受控比較,而且知道結果邊界的訓練系統? 這段歷史留下的重點不是一次成功的 checkpoint,而是如何讓「模型真的在學」和「程式只是正常執行」可以被分開檢查。
先確認模型到底收到了什麼
Breakout 的一個 state 不是單張 RGB 圖片,而是最近四張 84 × 84 灰階畫面疊在一起,所以環境交給模型的形狀是 (4, 84, 84)。四張畫面讓 Agent 有機會從位置變化推測球的運動方向;只看單張畫面,很多動態資訊會消失。
進入 PyTorch 的卷積神經網路(Convolutional Neural Network, CNN)之前,這個 state 會轉成 float32、除以 255,再補上一個代表「這是一批資料」的 batch 維度,成為 (1, 4, 84, 84)。一次真實 forward 的 shape 是:
(1, 4, 84, 84)
    → Conv1: (1, 32, 20, 20)
    → Conv2: (1, 64, 9, 9)
    → Conv3: (1, 64, 7, 7)
    → Flatten: (1, 3136)
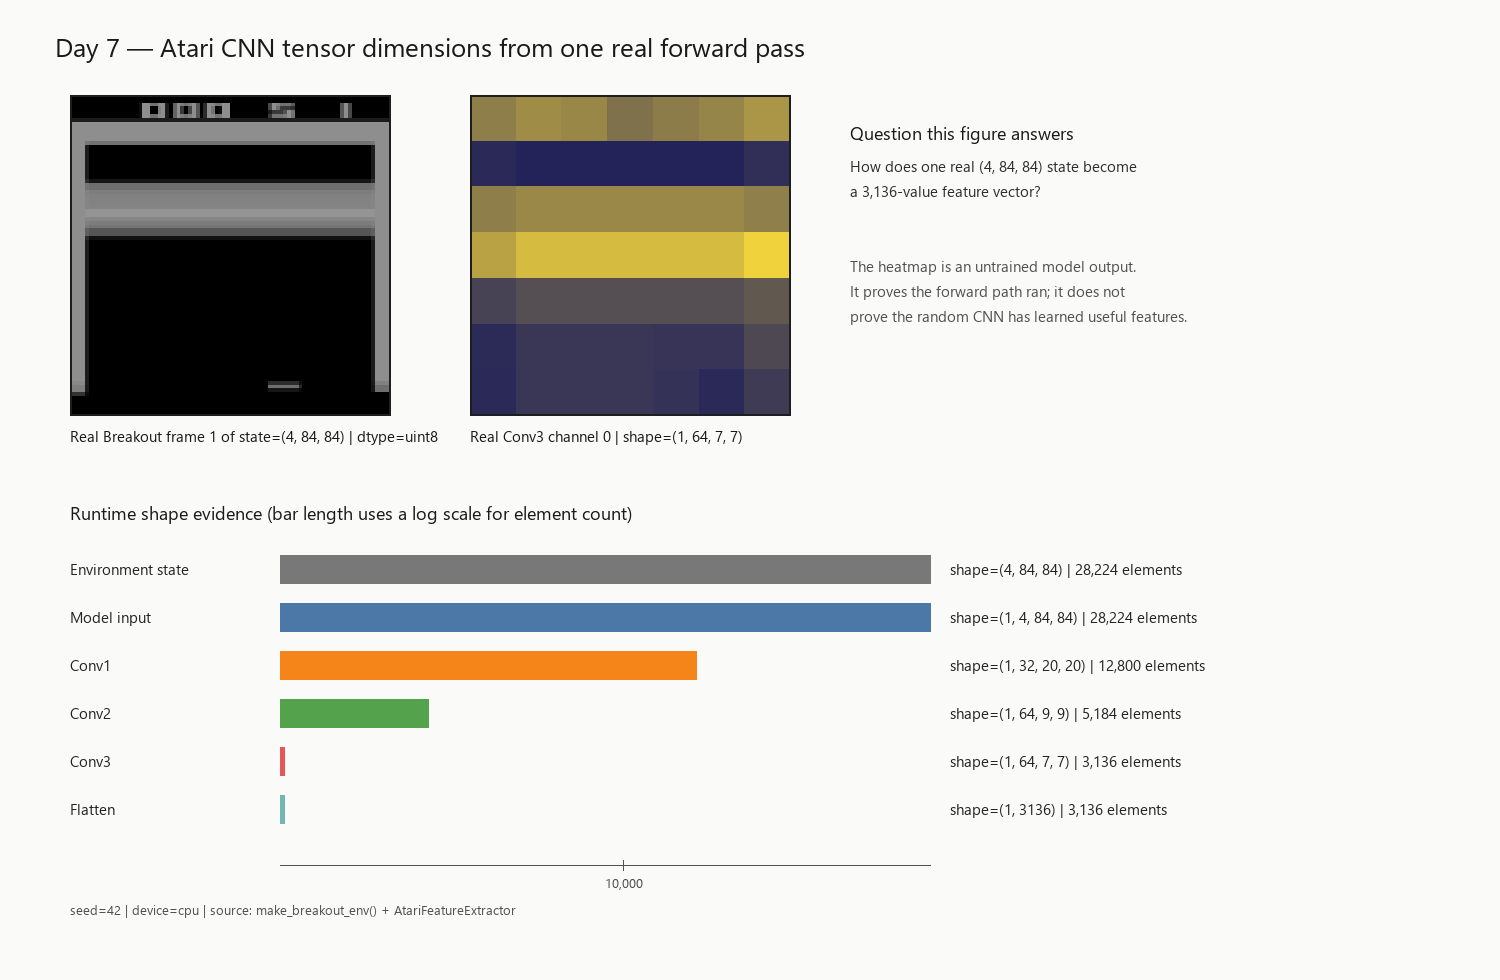
圖中的下半部是同一次 forward 的元素數量:輸入與補上 batch 維度後都仍有 28,224 個值,第三層卷積則產生 64 × 7 × 7 = 3,136 個 activation。這個圖回答的是「一個真實 state 如何變成 feature vector」;它不能證明尚未訓練的 CNN 已經學會辨識球或擋板。來源是 Day 7 的 CPU、seed 42 實際 forward,原始圖與重現命令保留在 Original Day 7 與其 cnn-dimensions.png。

CNN 的輸出還不是 action。DQN 接著把 3,136 個 features 交給 Q head,輸出四個對應 Breakout action 的 Q-value:Q(NOOP)、Q(FIRE)、Q(RIGHT)、Q(LEFT)。Q-value 是「在目前 state 做某個 action,之後依照策略繼續走,預期能得到多少 discounted return」的估計,不是機率;因此不應該接 Softmax,也不能把最大的輸出直接當成已經驗證過的好策略。
這個分界很重要:CNN 與 Q head 只回答「如何從畫面得到四個價值估計」,還沒有回答「用什麼資料修正估計」以及「怎麼知道修正沒有把系統弄壞」。
為什麼不能拿最新一筆經驗直接學?
Agent 每和環境互動一步,就會得到一筆 transition:
(state, action, reward, next_state, terminated, truncated)
如果模型每次只用最新的一筆資料更新,連續的 Atari 畫面會高度相似,訓練也會被遊戲時間順序綁住。DQN 因此使用 Replay Buffer:先保存過去的 transition,真正更新模型時,再從經驗池隨機抽出一個 mini-batch。這不會讓資料變成完全獨立,但至少不會每次都只看時間上相鄰的幾張畫面。
Replay Buffer 的保存格式也屬於訓練系統的契約。畫面以 uint8 保存 0..255 的 pixel,抽樣後才轉成除以 255 的 float32 Tensor;action、reward 與兩種 episode 結束訊號則分開保存。這讓儲存責任和模型計算責任分離,也保留了 terminated 與 truncated 的差異:前者是遊戲真的結束,後者是被外部限制截斷,例如時間上限。
這個直接保存 state 與 next_state 的版本容易檢查,但很吃記憶體。按照當時的 observation 與 dtype,capacity 10,000 / 100,000 / 1,000,000 約需要 0.526 / 5.258 / 52.584 GiB。這是設計取捨,不是數學必然;把相鄰 frame 只存一次可以省空間,卻必須額外處理 episode 邊界。先保留簡單且可驗證的版本,讓後續效能問題有清楚的基準,通常比一開始就把資料結構最佳化更可靠。
Replay 解決了「拿哪些歷史資料學」的問題,卻沒有解決「現在要選哪個 action」。如果永遠只選目前 Q-value 最大的 action,模型早期的錯誤高估可能讓 Agent 從此重複同一種行為。epsilon-greedy 在兩者之間加上一個明確的隨機分支:以 epsilon 的機率探索,以 1 - epsilon 的機率採用 greedy action。Day 13 的 10K run 中,random branch 有 4,754 次、greedy branch 有 5,246 次,epsilon 從 0.9 降到約 0.0501;這些數字能證明探索排程有運作,但不能證明 greedy action 已經是好策略。
讓學習目標不要每一步都追著自己跑
DQN 真正更新時,要把目前預測的 Q(s, a) 拉近一個由 reward 與下一個 state 算出的參考值。如果同一個 network 同時負責產生目前預測和參考值,optimizer 一改參數,參考值也會跟著變;模型等於一邊追答案,一邊改答案。
Target Network 是用來隔開這個移動目標的第二份模型。Online Network 持續被 optimizer 更新;Target Network 暫時保留較舊的參數,只用來估計下一個 state。經過一段 target_update_interval 後,再把 Online Network 的參數整份複製過去,這叫 Hard Update。兩次同步之間,Target Network 不參與 optimizer,也不需要 gradient。
等讀者知道兩個 network 各自負責什麼後,學習目標才值得寫成公式:
target = reward
       + gamma × (1 - terminated)
       × max Q_target(next_state, action)
gamma 控制未來 reward 的影響;terminated 為真時,遊戲真的到了終點,target 只保留目前 reward。truncated 不應該被自動當成 terminated,因為時間上限截斷的 episode 未必代表遊戲世界已經沒有未來。Day 11 的最小測試也確認了這個分工:同步後 Online 與 Target 輸出差距是 0,只更新 Online 後差距變成 0.00746517,再次 Hard Update 後又回到 0。這證明同步機制分開運作,不證明 DQN 已經學會 Breakout。
一筆 transition 怎麼變成一次模型更新?
有了模型、Replay、探索和 Target Network,還要把它們放進同一個時間順序。一次完整更新可以濃縮成:
與環境互動
→ 把 transition 放進 Replay Buffer
→ 累積足夠資料後抽出一批舊經驗
→ 取出當時真正做過的 action 對應 Q-value
→ 用 Target Network 算 Bellman target
→ 計算 Huber loss
→ 只更新 Online Network
→ 到同步時機才更新 Target Network
這裡有兩種不能混為一談的 step。Environment step 是 Agent 呼叫一次 env.step(action);optimizer step 則是模型真的用一個 batch 修改一次參數。Day 12 的 smoke run 固定 learning_starts = 32、train_frequency = 4、batch_size = 8,跑 1,000 個 environment steps,實際得到 243 次模型更新:
(1000 - 32) / 4 + 1 = 243
這個計算檢查的是訓練節奏,不是遊戲能力。固定 seed 42 的 CPU smoke run 完成 4 局,Replay Buffer 最後有 256 筆資料,Target Network 同步 11 次。回報是 2、3、0、0,樣本太少,不能支持「Agent 已經在進步」。
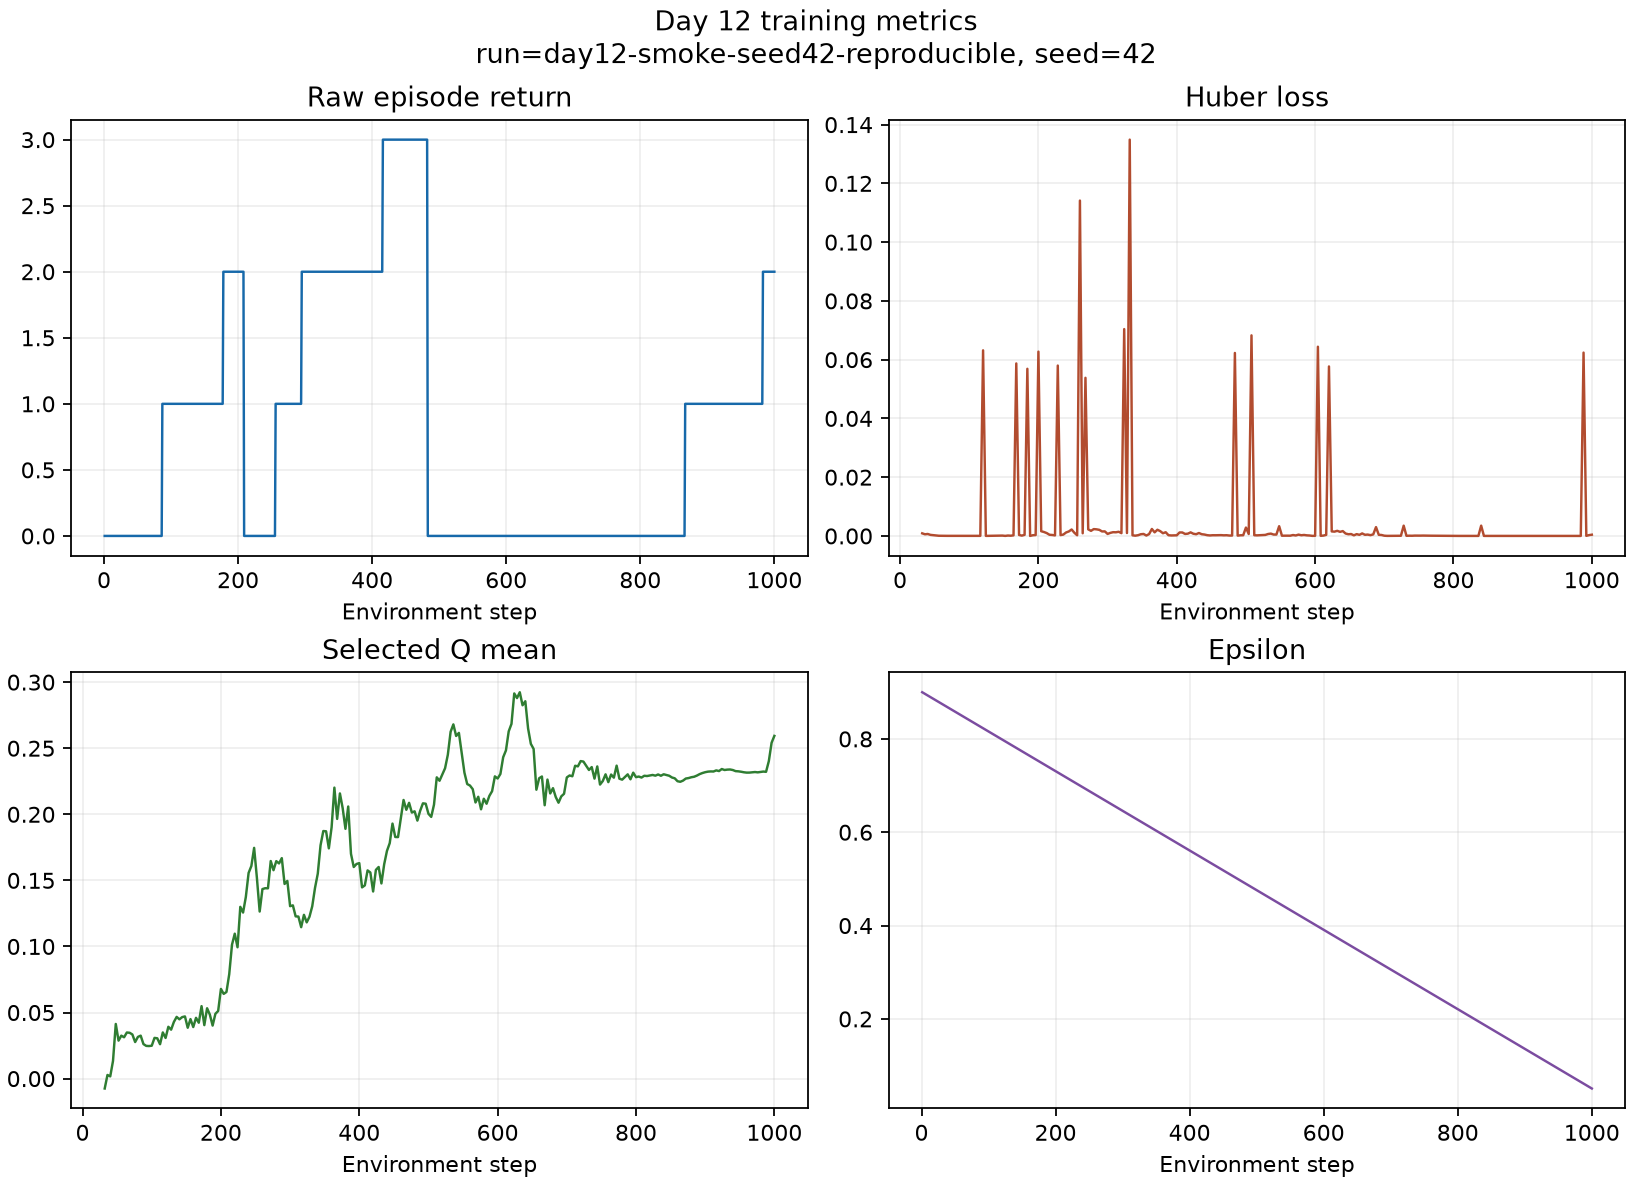
圖中的四個面板分別是 raw episode return、Huber loss、selected Q mean 與 epsilon。讀者應該注意的是:epsilon 確實下降,開始訓練後 loss 出現,Q-value 也在變;這支持「完整訓練閉環已接通、Online Network 確實被更新」。它不能支持「分數已經有可靠上升趨勢」。圖來自 Day 12 的 day12-smoke-seed42-reproducible run,原始 training-overview.png 與 smoke run 說明 保留了 seed 與觀察範圍。

訓練 reward 和評估分數也要分開。當時訓練可把正 reward、零 reward、負 reward 分別裁成 +1、0、-1,讓更新的數值尺度比較穩定;但評估 Agent 時,仍然要累加 Atari 環境原本回傳的 raw reward。若把兩者混成同一個數字,模型可能看起來「分數變好」,實際上只是改了 reward 的表示方式。
程式正常更新,為什麼還要除錯?
強化學習最麻煩的 bug 往往不會讓程式 crash:action 可能都合法,Q-value 也可能維持正確 shape,但模型一直選錯;loss 可能很小,卻只是貼合一批偏掉的 target。比較安全的順序是先排除學習流程錯誤,再看數值健康,最後才看探索、資料與遊戲分數。
第一關是 fixed-batch overfit:固定一小批 transition 和固定 target,讓模型重複更新 200 次。這刻意移除了會變動的環境與資料,若連這份「小考」都背不起來,就不該先怪 Breakout 太難。RTX 4060、seed 42 的實驗把 loss 從 0.2029491961 降到 0.000000001456,支持基本的 Q-value 預測、loss、反向傳播與 optimizer 更新路徑能工作;它不代表 Agent 會玩遊戲。
第二關是看真正 10K-step CUDA debug run 的內部訊號。這次完成 48 局、2,251 次模型更新、21 次 Target Network 同步;loss 平均約 0.00299、最大約 0.0463,全部維持有限值。Q-value 和 Target max 的上緣、以及 gradient norm 在後段確實有抬高,但沒有同時出現 loss 長期爆大或 NaN / infinity,因此比較準確的判讀是「需要持續監看」,不是「已經發散」。
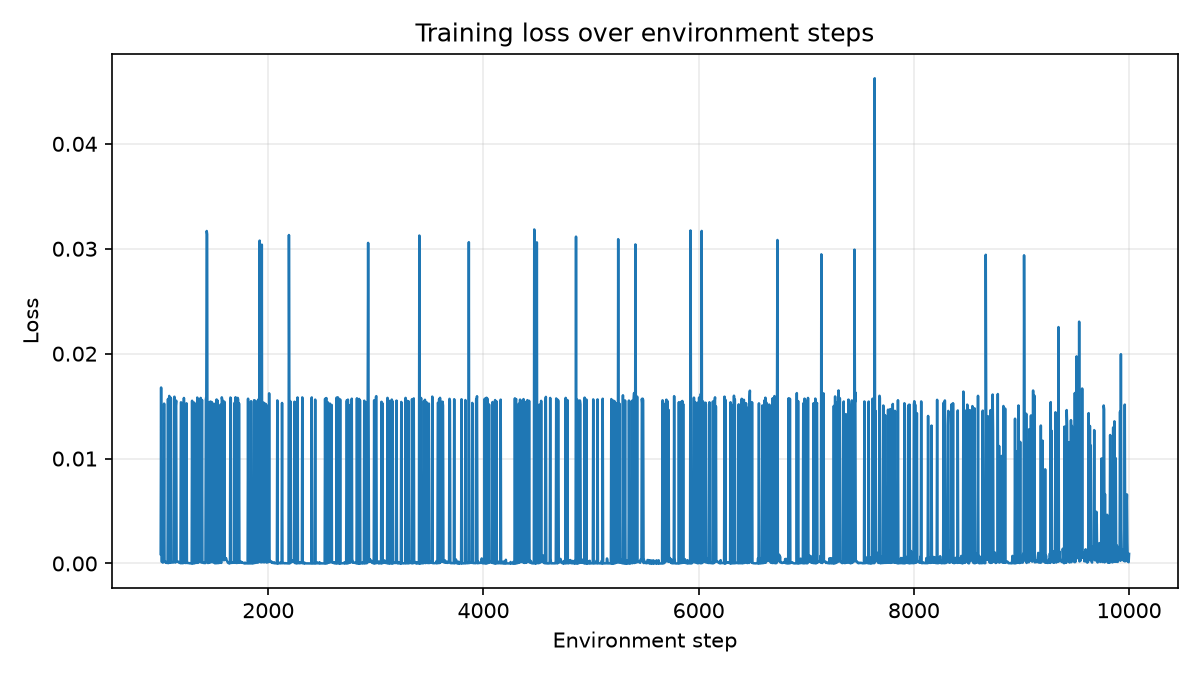
這張圖的橫軸是 environment step,縱軸是每次更新的 Huber loss;尖峰代表某些 mini-batch 的 prediction 與 target 差距較大。圖能支持「loss 有波動但這次仍為有限值」,不能只靠一個尖峰判定 Target sync 造成問題,也不能把 loss 變小當成遊戲能力的證明。來源是 Day 13 的固定 seed 42、cuda:0、10K run;原始 loss-curve.png 對應 debugging article。

第三關才看 Agent 收集到的資料與短期 return。10K run 的四個 action 都曾出現:NOOP 2,512、FIRE 2,546、RIGHT 2,841、LEFT 2,101;Replay Buffer 也已填滿 10,000 筆。可是 48 局 raw return 只有 0..5、平均 1.40,不能得到可靠的學習趨勢。這種結果仍然有價值,因為它把「好像沒在學」拆成了可以逐一檢查的問題,而不是立刻用學習率掩蓋可能的實作錯誤。
調參前,先把實驗問題固定下來
Day 14 把 10K 當健康檢查,把 100K 當較長的觀察窗口;100K 不是保證學會 Breakout 的門檻,只是降低少數 episode 的短期運氣主導結論的機會。這個區分很重要:短跑用來回答「流程能不能跑」,長跑才開始回答「不同設定是否出現可解釋的差異」。
在同一個 seed 42、同一組主要條件下,只改 learning rate 的 100K 結果如下。這裡的 2e-4 是候選設定,不是被證明的最佳答案:
| 設定 | 完成回合數 | 最近 20 局平均 | 中位數 | 最佳 20 局移動平均 |
|---|---|---|---|---|
1e-4 | 364 | 5.15 | 5.50 | 5.15 |
5e-5 | 389 | 1.80 | 2.00 | 2.90 |
2e-4 | 308 | 9.15 | 8.00 | 9.15 |
較高 learning rate 這一組在這個 seed 的後段表現較高,但一次 seed 不能支撐「最佳學習率」的宣稱。它只能說明 2e-4 值得進入下一輪驗證。相同的克制也出現在效能比較:完整單環境訓練中,CPU Replay 加預先配置傳輸緩衝區是 361.61 env steps/s,GPU-resident Replay 是 338.13;GPU 內部的局部抽樣更快,不代表整條「環境互動 → 寫入 Replay → 模型更新」流程更快。
這些實驗也說明為什麼要保存 seed、裝置、版本、Git commit、訓練設定與環境設定。當一次 run 失敗或結果混合時,下一個人才能知道是在比較 learning rate,還是在不知不覺中比較了資料路徑、探索排程或環境規則。
評估不只是看平均分數
100K checkpoint 的正式評估把模型凍結,設 epsilon = 0,與 Random Policy 一起跑相同的 15 個固定遊戲起始條件,分數使用 raw Atari reward。這樣才把「還在學」和「固定模型的行為」分開。原始比較確實得到:Random 平均 1.33、DQN 平均 4.53,中位數則是 1 對 5。
但同一批資料還顯示:Random 的 15 局全部 terminated;DQN 只有 5 局正常結束,10 局被 TimeLimit 截斷,而且那些局幾乎都停在 26,993–27,000 agent steps。Atari 的 episode 上限是 108,000 raw frames,而目前每個 agent action 前進 4 frames,所以:
108,000 / 4 = 27,000 agent steps
因此 18,131 的平均局長不是生存能力的直接證據,而是一個應該被拆開的診斷訊號。
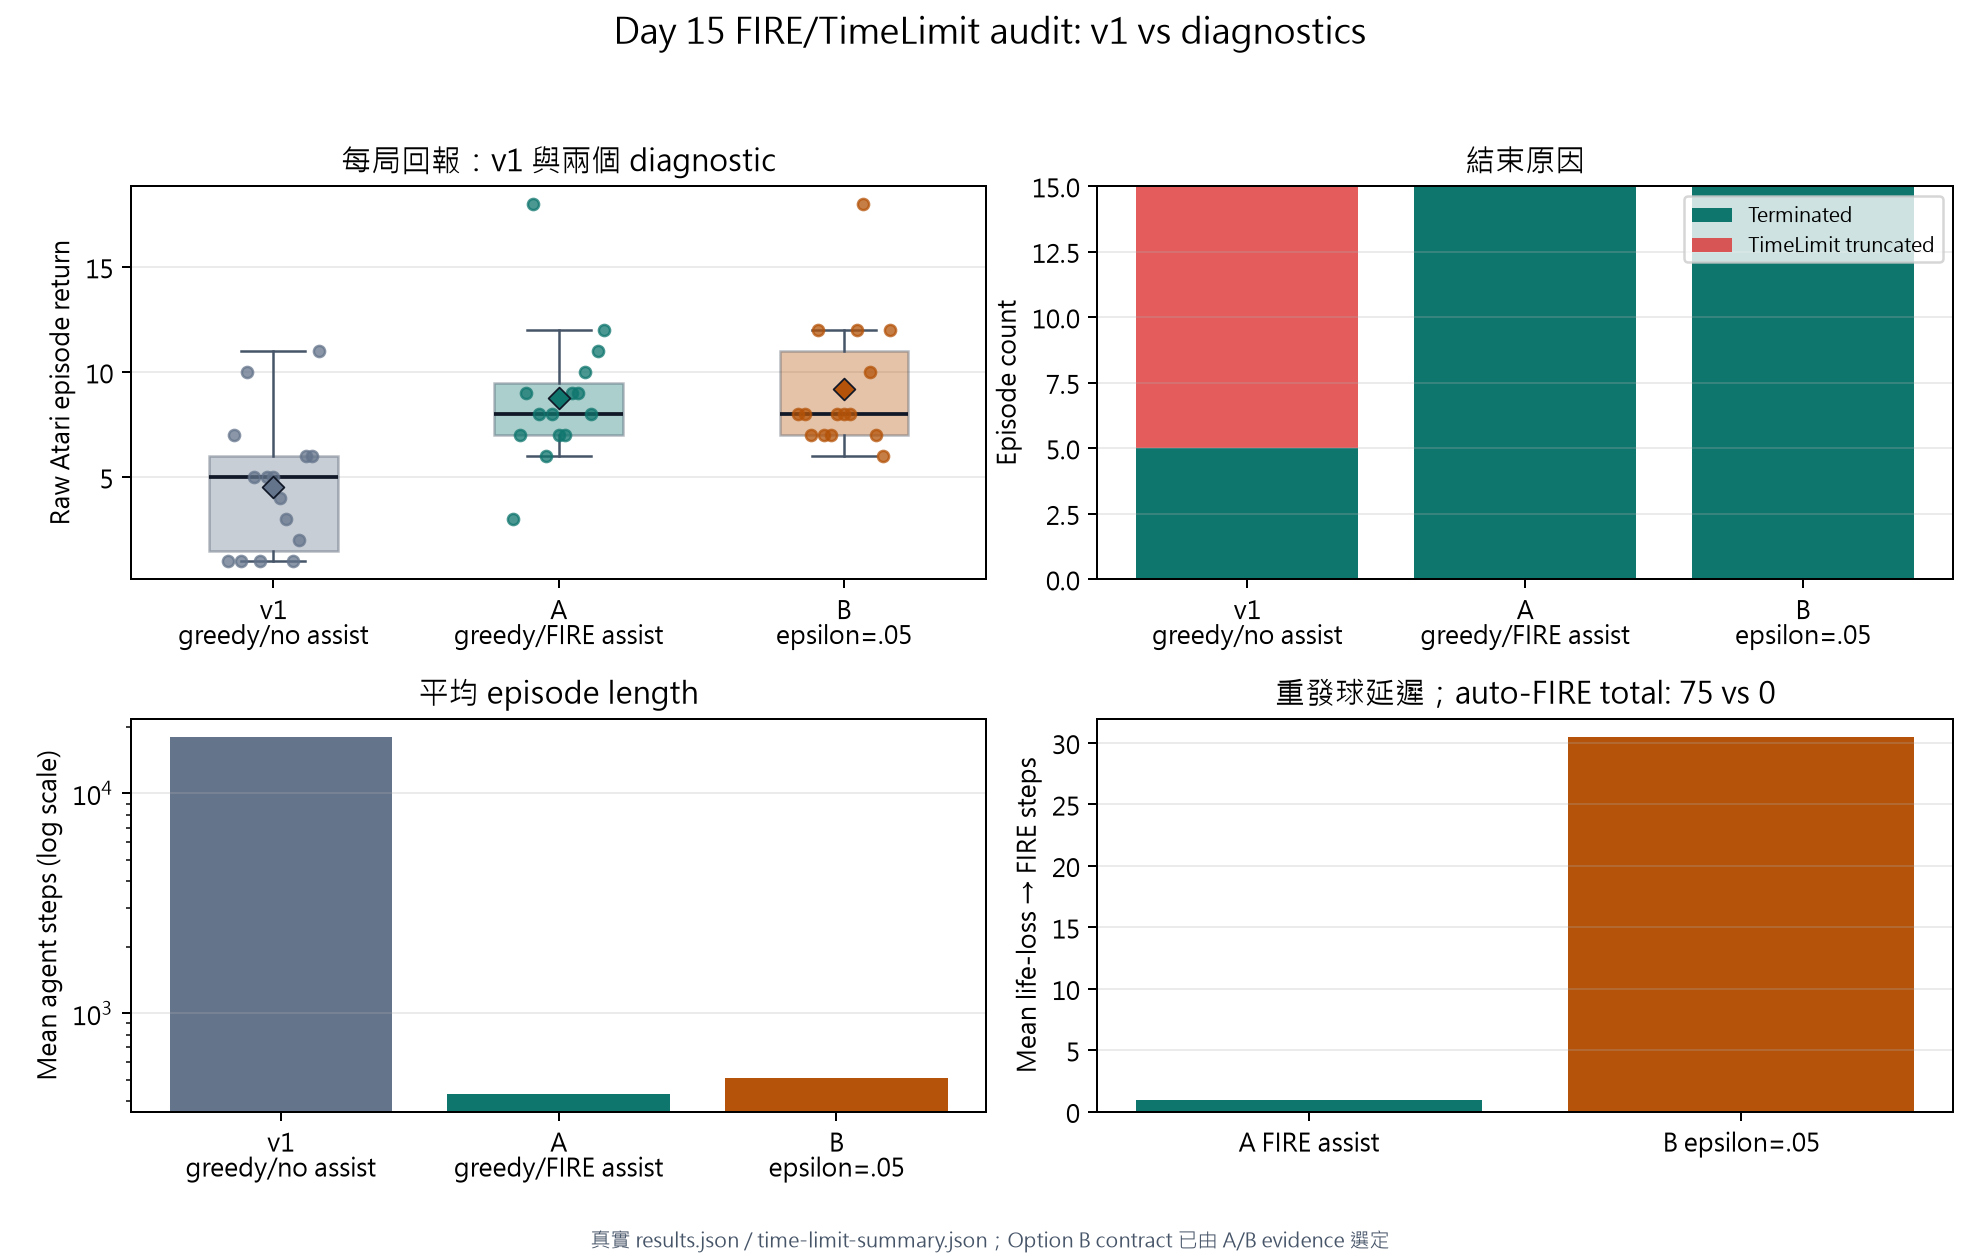
圖的左上比較三種模式的每局 raw return;右上把 15 局的結束原因拆成 terminated 與 TimeLimit truncated;左下以對數軸顯示平均 episode length;右下則顯示掉命到下一次 FIRE 的延遲。最值得注意的不是哪個平均分數最高,而是原始 greedy 評估有 10/15 局被截斷,FIRE assist 與保留 epsilon = 0.05 的兩組則都是 15/15 正常結束。圖來自 Day 15 的 fire-time-limit-diagnostics.png;它能指出評估協定造成的 deadlock,不能單獨證明哪一種規則在所有未來實驗都最好。

追查 seed 101 後,問題變得具體:DQN 在第 54 個 agent step 掉命,直到第 16,449 step 才第一次再次選到 FIRE,中間相隔 16,395 steps;那段期間約 96% 的 observation 幾乎沒變,約 96% 的 action 是 RIGHT。另一個 TimeLimit seed 103 也出現相似模式。相反地,正常結束的 seed 102 在第一次掉命後 33 steps 就重新 FIRE。
Breakout 的 serve 規則解釋了這個現象:開局和掉命後都需要 FIRE 才會重新發球。模型沒有按 FIRE 時,畫面會停在等待狀態;若 greedy Q-value 又偏向 RIGHT,就形成:
RIGHT → 幾乎相同的畫面 → RIGHT → 幾乎相同的畫面 → …
訓練時的 epsilon = 0.05 偶爾會隨機選到 FIRE,像是替模型提供了偶然的逃生路徑;正式 greedy 評估移除這個隨機性,deadlock 才完整暴露。這就是為什麼一個「更 deterministic」的評估,反而讓環境契約的問題更容易被看見。
為了拆開 FIRE 的影響,Day 15 在相同 100K checkpoint、相同 15 個起始條件下做了兩個對照:一組保持 epsilon = 0,由環境在開局與掉命後自動 FIRE;另一組不提供 FIRE assist,但恢復訓練時的 epsilon = 0.05。
| 評估模式 | epsilon | 環境自動 FIRE | 平均 raw reward | 正常結束 | TimeLimit | 平均局長 |
|---|---|---|---|---|---|---|
| 原始 greedy | 0.00 | 否 | 4.53 | 5/15 | 10/15 | 18,131 |
| FIRE assist | 0.00 | 是 | 8.80 | 15/15 | 0/15 | 430 |
| 保留探索 | 0.05 | 否 | 9.20 | 15/15 | 0/15 | 509 |
這裡不應該直接選平均分數最高的 9.20。保留探索確實在這批測試中解除了 deadlock,但重新發球時間會依隨機性而變,這會把等待運氣混進模型比較。最後的工程選擇是把 serve 當成環境規則,讓 Agent 專心學移動擋板與擊球;之後的 training 和 evaluation 都必須使用同一套 FIRE 規則。舊的 4.53、1.33 仍然保留,因為它們正是發現問題的證據,但屬於舊的 Contract v1,不能直接拿來和新規則下的模型家族排名。
從這段歷史得到的可信度標準
Days 7–15 沒有證明「DQN 已經解決 Breakout」。它證明的是一套比較可靠的判斷順序:
- 先確認 state、shape、action 對應與資料 dtype 沒有在模型邊界悄悄變形。
- 再確認 Replay、探索、Target Network 與 optimizer 真的按照預期互動。
- 用 fixed-batch overfit 排除最小學習流程的錯誤,再用 loss、Q-value、Target、gradient、action distribution 和 Replay size 觀察真正的 run。
- 把 10K 健康檢查和 100K 學習比較分開,一次只改一個主要變因。
- 評估時固定 checkpoint、起始條件、epsilon、raw reward 與 episode 結束語意,並追查異常的局長而不只看平均分數。
因此,可信的 DQN 結果不是一條漂亮的 return curve,而是模型、環境、資料、診斷訊號和評估協定一起留下的證據鏈。當 4.53 > 1.33 同時伴隨 10 局 TimeLimit 時,正確的反應不是刪掉分數,而是保留分數、追查原因,再把協定修正到後續比較真正回答同一個問題。
這也留下下一個自然問題:當 FIRE 規則固定後,單一環境與單一 action inference 成為訓練瓶頸,怎麼擴展到多環境並行,又不改變原本的環境語意?那是 Core Series 下一個階段的問題;本篇只把能跑、能除錯、能評估的 DQN 基礎邊界固定下來。
來源與可重現性
本文是對 Original Breakout Ironman Days 7–15 的 Editorial Distillation,不是逐篇複製。來源 branch 的 immutable commit 是 f85038c2a8d3a12d4b524c0ff86c125a92b8d475;完整歷史入口也保留在 iThome Breakout Series。圖表、數字與實驗條件以該 commit 下的 Day 7、9、11、12、13、14、15 文章及 assets/day07、day12、day13、day15 為準。
文章中的觀察分成三種:shape 圖與訓練圖是來源 run 產生的實際輸出;FIRE 結果是固定 checkpoint、15 個起始條件的歷史評估;「Target Network 讓條件更穩定」與「探索可能解除 deadlock」則是根據這些觀察提出的機制解釋,不是跨 seed 或跨環境的普遍保證。後續若要比較新的模型,必須重新確認 runtime、environment contract、checkpoint 與完整 evaluation protocol。