Article · Writing
把 DQN Agent 搬進瀏覽器:環境一致性、WebGPU 與互動展示
把訓練完成的 DQN 從 ONNX 推論搬到瀏覽器,理解 WASM、WebGPU、ALE 與 Human-vs-Agent 展示之間的環境契約與證據邊界。
Evidence trail
Provenance
這篇內容的 canonical URL 是 /writing/browser-deployment-for-dqn/,發布日期為 2026年9月22日。
相關 Project 證據與實作:https://github.com/Tommyweige/breakout-rl-engineering
這篇內容也保留在其 Series 關係中;正文不需要依賴前一篇才能閱讀。
相容的歷史路徑:/posts/browser-deployment-for-dqn/

文章目錄
把一個 ONNX 檔案放進網頁,並不代表 DQN Agent 已經成功搬家。模型可以在瀏覽器裡輸出四個數字,但如果瀏覽器產生畫面的方式、動作編號或遊戲重設規則不同,這些數字就不再是在原本的 Breakout 問題上做決策。
這篇文章要回答的問題是:如何把訓練完成的 Agent 與它依賴的環境契約一起搬進瀏覽器,最後做成真的 Human-vs-Agent 互動產品? 原始 Ironman 的 Day 27–30 是這段工作的歷史來源;本文把它重新整理成一條從推論驗證、環境對齊到產品證據的路徑。
先把模型搬進瀏覽器,能證明什麼?
訓練完成的 PyTorch 模型先被匯出成 ONNX。ONNX 可以把模型的計算圖交給不同執行器,而在瀏覽器裡,這個執行器是 ONNX Runtime Web:它讓使用者的瀏覽器直接載入模型並計算,不需要每個畫面都送回 Python 伺服器。
目前 Breakout repository 的 web application 也採用這個 client-side 路徑:瀏覽器同時執行 Atari environment 與 policy inference,產品不依賴 Python backend。WASM(WebAssembly)是第一個可攜的執行方式;WebGPU 則是另一個可以請瀏覽器 GPU 執行同一份 ONNX 的 provider。這兩者改變的是「在哪裡算」,不是模型本身。
最早的瀏覽器版本刻意只驗證模型,還沒有假裝已經接上完整遊戲。它載入 FP32 ONNX、讀取鍵盤輸入,並把四個 action 的 Q-value 顯示出來;畫面上明確寫著 ALE gameplay not connected yet。這個界線很重要:模型推論通了,只代表瀏覽器可以對固定輸入做計算,還不能代表 Agent 已經在玩 Breakout。
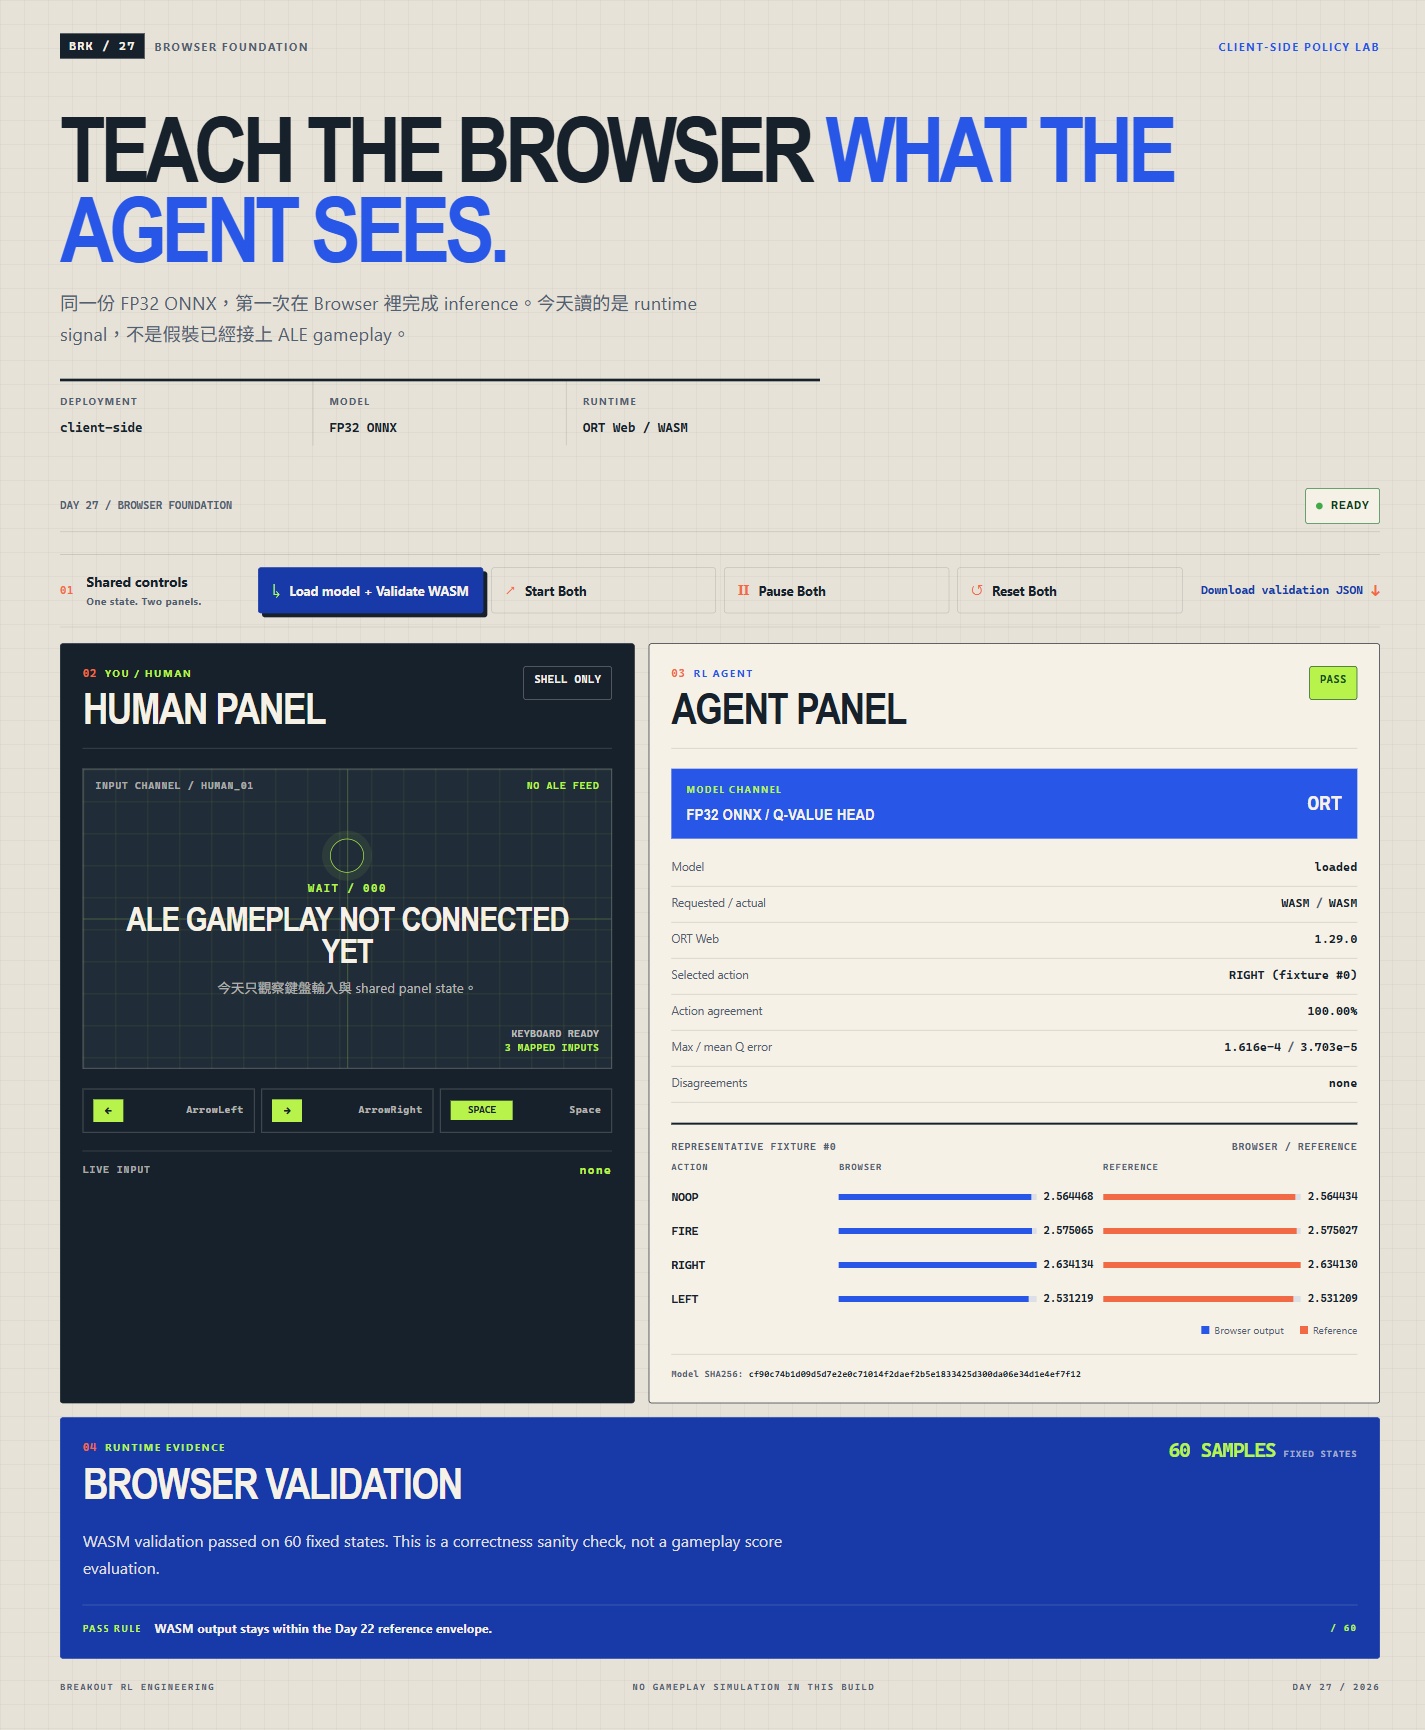
圖 1|原始 docs-ironman-series 的真實瀏覽器驗證畫面。它顯示的是 60 個固定狀態的 WASM inference correctness sanity check,不是完整遊戲分數評估;來源為 Breakout repository 的文件分支。
為什麼模型相同,Agent 還是可能變成另一個 Agent?
DQN 的輸入不是一張任意圖片,而是一個有固定形狀與數值範圍的 observation。現在的 inference spec 把它定義成 float32、[N, 4, 84, 84],也就是四張 84×84 灰階畫面組成的 frame stack,像素值只除以 255 一次;輸出則是四個 raw Q-value,依序代表 NOOP、FIRE、RIGHT、LEFT。
這些資料必須由瀏覽器的 Atari environment 以同樣語義產生。現行 Contract v2 固定了 ALE/Breakout-v5、frame_skip = 4、frame_stack = 4、sticky_action_probability = 0.25、FIRE reset,以及「掉一條命不立刻終止 episode」等條件。瀏覽器端的程式會載入這份 contract,並用 inference spec 中的 SHA-256 驗證它沒有被換成另一份設定。
其中最容易被忽略的是 action mapping。模型的輸出 index 是連續的四個位置,但 ALE 的 minimal action set 使用的實際代碼是另一組數字:
| 模型語意 | 模型 index | ALE action code |
|---|---|---|
NOOP | 0 | 0 |
FIRE | 1 | 1 |
RIGHT | 2 | 3 |
LEFT | 3 | 4 |
所以不能把模型輸出的 2 直接送給 ALE,因為 2 在這裡不是 RIGHT 的 ALE code。瀏覽器必須先把 index 還原成 action 語意,再轉成環境理解的代碼。初始發球或掉命後的 FIRE 也由 environment contract 的 reset 邏輯處理,而不是把一次性的環境動作誤算成 policy 已經學會的選擇。
前處理同樣是契約的一部分。瀏覽器會把 ALE 的 RGB frame 轉成灰階,將相鄰畫面依 Atari preprocessing 的規則合併,再縮放成 84×84,最後推進四張畫面的 stack。這些步驟看起來只是影像處理,但它們決定了 ONNX 看到的每一個數字;只要順序或 rounding 不同,後續 action 就可能分叉。
先驗證單一步驟,再讓遊戲跑起來
整局遊戲不是最容易除錯的驗證單位。若第一個 action 就不同,下一張畫面會不同,之後整局都會越走越遠;最後只看到分數不同,卻不知道問題出在模型、resize、seed 還是 action code。
因此 Day 27 先準備 60 個固定的 observation,讓 Python reference 與瀏覽器 WASM 各算一次,並比較 Q-value 與最後 action。原始紀錄中的最大絕對差約為 0.0001616、平均差約為 0.0000370,60 個狀態的 action 全部一致。這個結果支持的是「這批固定輸入上的推論行為相符」,不是「Agent 已經學會所有 Breakout」。目前 web-model-manifest.json 仍保留 60 個 fixture 的數量、模型 hash 與 reference artifact,瀏覽器也會以實際建立的 provider 產生驗證結果。
接著才測 WebGPU。Day 28 的歷史 benchmark 在特定 Chrome、硬體、小型 DQN 與 batch-one 條件下,WASM 的 P50 約 0.995 ms,WebGPU 約 3.985 ms;WebGPU 沒有算錯,卻因為工作量小、每次啟動 GPU 與等待結果的成本高,反而比較慢。這不是 WebGPU 的普遍定律,只是這個模型與測量條件下的觀察;部署時必須把「結果一致」與「速度更快」分開驗證。
現行程式對兩種 backend 的處理也不一樣。正式 validation 會要求 requested provider 真正建立成功:要求 WebGPU 卻沒有建立出 WebGPU session 時,驗證會失敗,不會把 WASM 冒充成 WebGPU。互動 gameplay 則採用有明確證據的 fallback:先嘗試 WebGPU,若 provider 初始化失敗,才改用 WASM,並在 debug diagnostics 顯示實際使用的 backend。這讓「瀏覽器支援 WebGPU」與「這一局遊戲真的由 WebGPU 執行」不會被混成同一件事。
環境對齊後,才有資格比較整局遊戲
當固定 observation 的 inference 對得上,下一個問題是瀏覽器自己的 ALE 是否產生了同一類的遊戲狀態。這需要把 reset、NOOP 起始步數、frame skip、frame stack、FIRE 行為、action mapping 與 episode limit 一起放進測試,而不是只檢查畫布上「看起來像 Breakout」。
原始 Day 29 的報告曾記錄固定 seed 的 native 與 browser episode score 對照,以及 WASM 與 WebGPU 各 30 局的瀏覽器評估。這些數字是歷史文件分支在當時 runtime 上留下的證據,應與目前 main 的實作證據分開閱讀。現行程式確實能在瀏覽器中跑多局 evaluation,逐局保存 seed、score、action trace、auto-FIRE 次數與 preprocessing/inference timing;但它的 Contract v2 parity 狀態仍明確標成 partial,未獨立建立 Python cv2.INTER_AREA 的 byte-for-byte parity,也未獨立建立 ALE/browser seed stream equivalence。因此目前不能把「瀏覽器能跑完 30 局」誇大成「已證明所有 native 分數逐局相同」。
這個保守的標記不是產品失敗,而是證據邊界。它告訴讀者:瀏覽器 runtime、模型輸入輸出與遊戲流程已經有可執行的 contract;跨 runtime 的 seed 與 resize 等價性仍需要另外的 differential audit,不能用一張漂亮的畫面代替。
Human-vs-Agent 展示為什麼要兩個 environment?
產品最後不是讓人類和 Agent 輪流控制同一局遊戲,而是在同一個頁面建立兩個獨立的 ALE instance。左邊的 Human Panel 接收鍵盤或滑鼠;右邊的 Agent Panel 讀取自己的 observation,交給 ONNX Runtime Web,選擇 action,再把動作送回自己的 Atari environment。兩邊可以一起 Start、Pause 或 Reset,但球、磚塊、生命、分數與遊戲狀態互不共享。
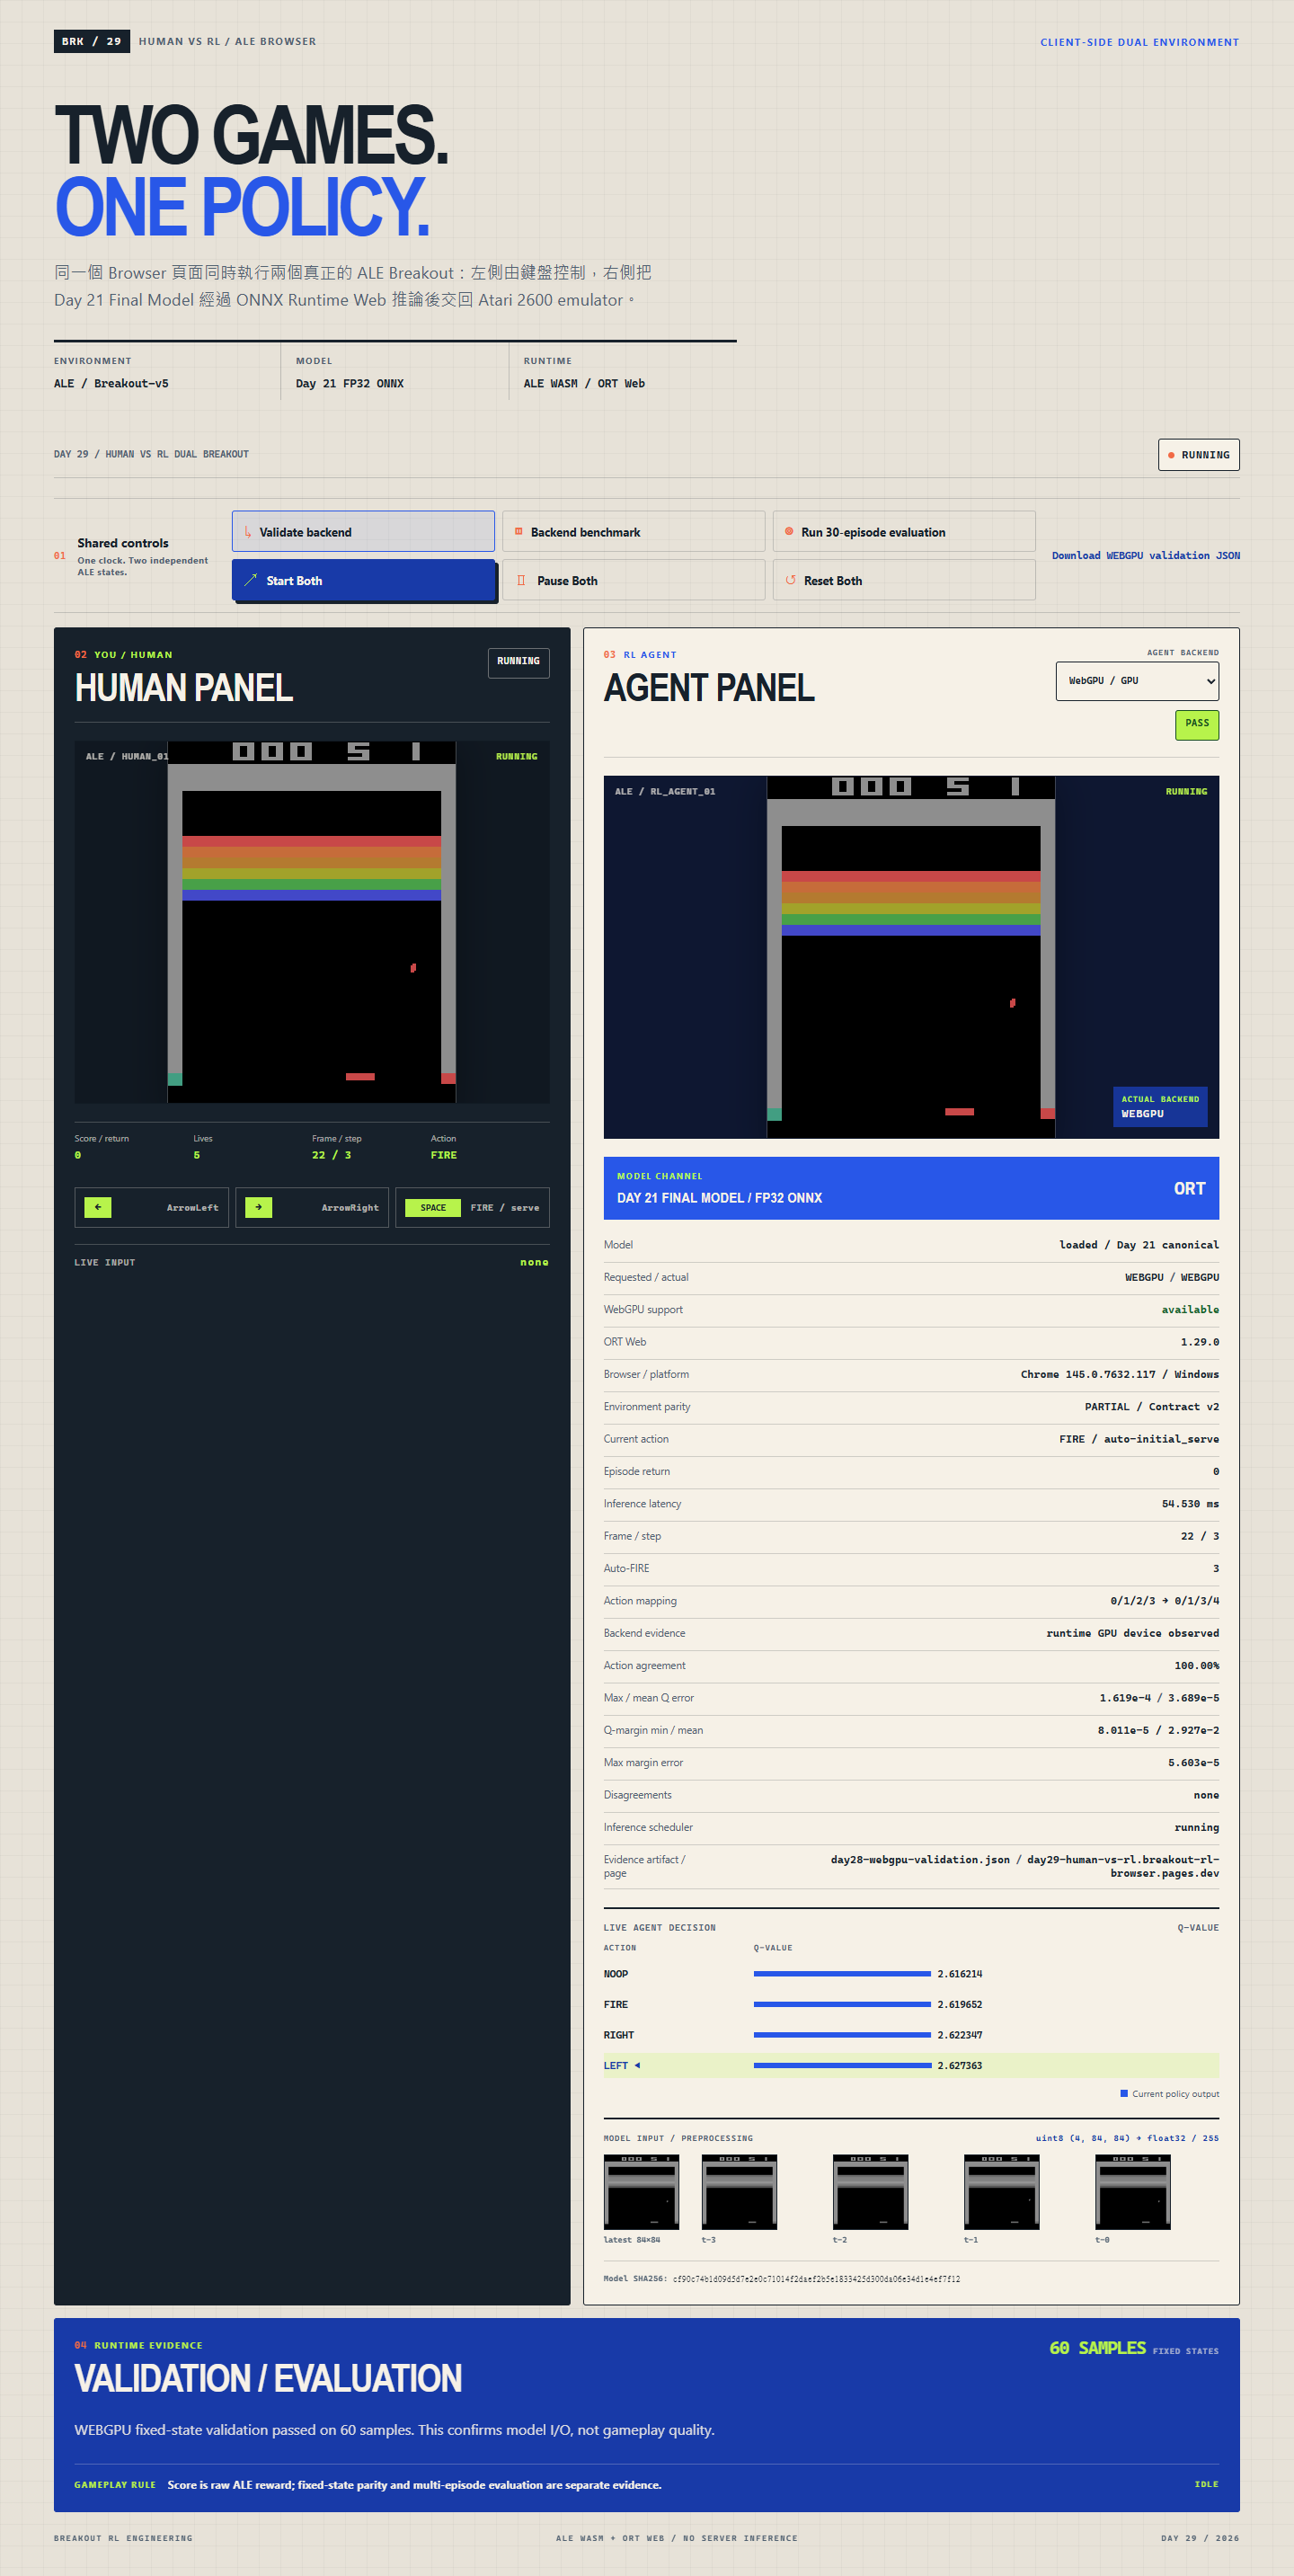
圖 2|原始文件分支中的真實雙欄 runtime 畫面:左側是 Human,右側是 RL Agent;圖中同時保留 backend、model、action mapping 與 validation 狀態。它證明的是當時頁面確實執行了雙環境互動,不是對所有硬體與瀏覽器的普遍效能保證;來源為 Day 29 artifact。
這個產品入口現在仍可直接開啟:breakout.tommypan.dev。它是實際部署的瀏覽器應用,不是假造的文章專用儀表板;runtime model、ALE WASM 與 TypeScript/Vite web application 都保留在 目前的 repository。瀏覽器畫面可以證明產品路徑真的存在,但不能單獨證明訓練品質、跨裝置 parity 或每一局的分數分布。
搬進瀏覽器的其實是一條證據鏈
這段工作的結論不是「WebGPU 比 WASM 好」,也不是「模型放進網頁就完成部署」。比較可靠的理解方式是:一個可用的 browser Agent 至少由四段接起來:
- 模型格式:PyTorch checkpoint 匯出成 ONNX,並保留模型 hash。
- 推論 runtime:ONNX Runtime Web 以 WASM 或 WebGPU 建立明確 provider;實際 backend 要可觀測。
- 環境契約:ALE、reset、frame skip、frame stack、前處理、FIRE 與 action mapping 必須和訓練/評估語義對齊。
- 產品與證據:Human 與 Agent 使用獨立 environment;固定狀態、真實 runtime artifact 與多局 evaluation 各自回答不同問題。
因此,這篇 Core Series 的答案是:DQN Agent 可以被搬進瀏覽器,而且可以做成不依賴 Python backend 的真實互動產品;但「模型能推論」、「遊戲能執行」、「WASM 與 WebGPU 行為一致」以及「瀏覽器與 native 完全 parity」是四個不同強度的主張。 現行 evidence trail 已支持前兩者與 provider 可觀測性,跨 runtime seed/resize parity 則仍保留為 partial。
如果要繼續追問,下一個自然問題不是再做一張展示截圖,而是如何把 browser 與 native 的 seed stream、resize rounding 與 episode trace 做成可逐步比對的 differential contract。那會決定這個瀏覽器作品能不能從「可操作的展示」再往「可獨立驗證的部署 artifact」前進。
證據入口
- Current web README:瀏覽器部署架構與不依賴 Python backend 的說明。
- Inference spec:模型輸入、輸出與 action meanings。
- Browser Contract v2 implementation:runtime contract 與
partialparity 邊界。 - ONNX Runtime Web policy:explicit provider、實際 backend 與 WASM/WebGPU 行為。
- Original Ironman Days 27–30:歷史來源文章與當時的 runtime evidence。