Article · Writing
從 Atari 畫面到 Q-Learning:建立可靠的 Breakout RL 基礎
從 ALE 與 Gymnasium 的互動契約、畫面預處理與 frame stacking,到 reward、Bellman target 與 Q-Learning,整理 DQN 開始前必須先固定的 Breakout RL 基礎。
Evidence trail
Provenance
這篇內容的 canonical URL 是 /writing/breakout-rl-foundations/,發布日期為 2026年9月22日。
相關 Project 證據與實作:https://github.com/Tommyweige/breakout-rl-engineering
這篇內容也保留在其 Series 關係中;正文不需要依賴前一篇才能閱讀。
文章目錄
一個 Agent 能在畫面上移動球拍,不代表我們已經有了一個可靠的強化學習(Reinforcement Learning,RL)系統。只要同一個 step 的邊界、畫面整理方式或 reward 定義不同,兩次訓練就可能其實是在解不同的問題。
所以在寫 DQN 之前,真正該先回答的問題是:一次 Atari 互動到底代表什麼?
這篇文章把 Original Breakout Ironman Series 的前六篇內容重新整理成一條因果路徑:先固定環境如何回覆,再決定 Agent 看見什麼,接著說清楚 reward 如何連到未來,最後用一個可追蹤的 Q-Learning 實驗說明價值如何被學出來。這些邊界固定後,DQN 才有一個能被檢查的起點。
Agent 和遊戲之間,先要有一份清楚的契約
如果 Agent 只是「看畫面、按按鈕」,我們很快會遇到一個問題:程式怎麼知道自己拿到的畫面形狀、可以送出哪些動作,以及一次動作結束後哪些資料屬於同一筆經驗?
這個專案使用 ALE/Breakout-v5。Arcade Learning Environment(ALE)負責執行 Atari 遊戲規則、畫面更新與分數;Gymnasium 則提供一致的 reset() 和 step() 介面,讓 Agent 不必直接處理模擬器內部細節。這兩層合在一起,才形成可以被程式重複操作的環境。
重設環境後,Agent 先收到一張原始 RGB 畫面;在這個來源版本中,它的形狀是 (210, 160, 3),像素型別是 uint8。Breakout 的動作空間則有四個離散動作:NOOP、FIRE、RIGHT 和 LEFT,實際傳入的是整數 0 到 3。
一次互動的時間順序可以寫成:
observation, info = env.reset(seed=42)
next_observation, reward, terminated, truncated, info = env.step(action)
action 是 Agent 對目前畫面的選擇;環境執行它之後,才回傳下一個畫面與這一步的 reward。terminated 表示遊戲本身到達終止條件,truncated 則表示這一局因為外部限制而被截斷,例如時間上限。收集資料時,兩者任一為真通常都要開始下一局;但它們在計算未來價值時不能被不加說明地混成同一個訊號。
這一筆資料的核心不是 API 參數列表,而是時間邊界:
(state, action, reward, next_state, terminated, truncated)
如果這些欄位不是同一次互動的前後關係,後面再精密的模型也只是在學一筆被錯接的資料。
一張畫面為什麼還不夠?
原始畫面包含很多像素,卻不一定包含做決策所需的時間資訊。球出現在同一個位置時,它可能正往右下方飛,也可能正往左上方飛;只有一張截圖,這兩種狀況很難區分。
因此觀察值要先經過畫面預處理(preprocessing):把 RGB 轉成灰階,再縮小成 84 × 84。這不是把遊戲規則改掉,而是保留球、球拍和磚塊的相對位置,同時降低後續計算量。
接著還有兩個容易混淆的設定。frame skip = 4 表示 Agent 選定一個動作後,讓遊戲連續更新四次才重新決定;frame stacking = 4 則表示一次保留最近四張灰階畫面。前者控制決策頻率,後者補回球的短期移動方向,兩個數字相同但解決的是不同問題。
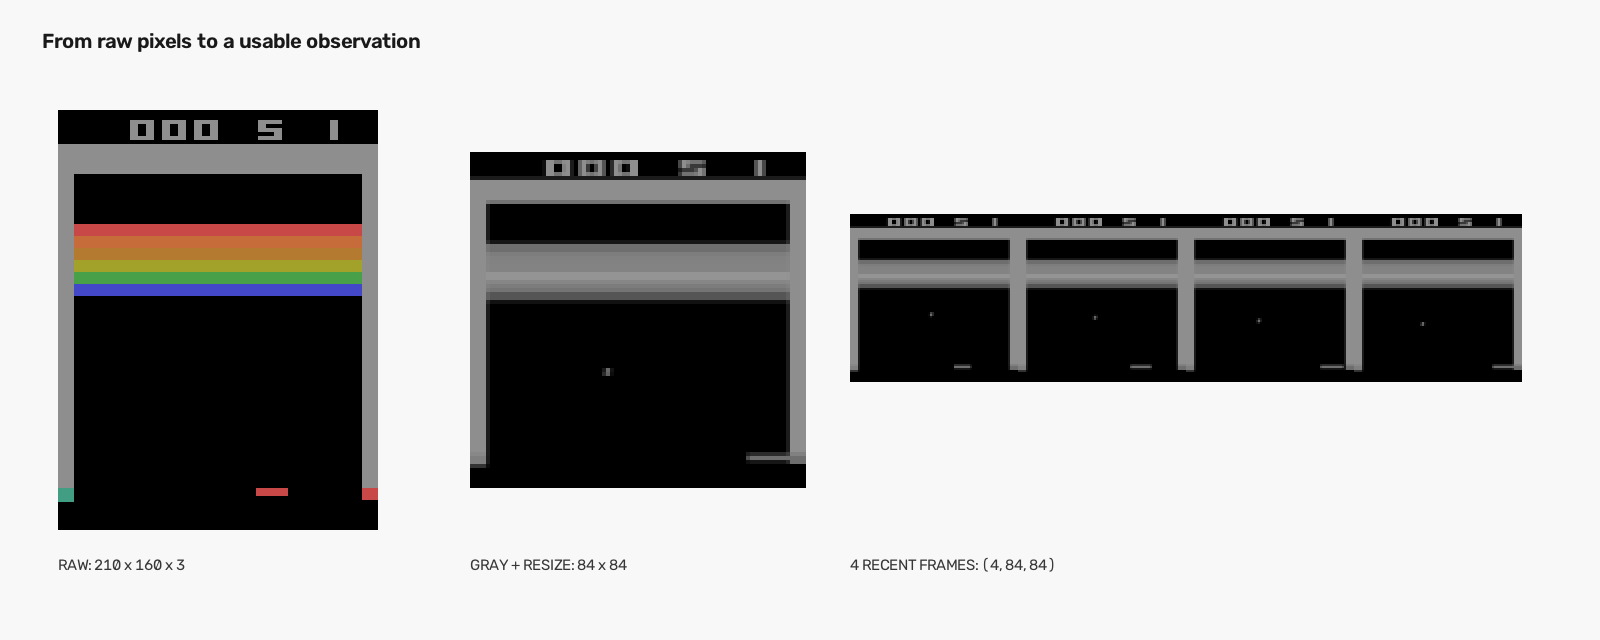
這張圖來自原始系列的實際預處理產物:(210, 160, 3) 先變成 (84, 84),最後以最近四張畫面組成 (4, 84, 84)。
遊戲剛開始時還沒有四張歷史畫面,實作會用第一張畫面填滿 stack;重新開始下一局時也會重新初始化,避免把上一局的結尾帶進來。畫面在保存和傳輸時仍可使用 uint8 節省記憶體,真正送入模型前再轉成小數並縮放到 0 到 1。
到這裡,Agent 的 state representation 已經不是「一張圖片」,而是四個連續時間點的 (4, 84, 84) 輸入。這仍然是對遊戲內部狀態的實用近似,不是已經證明完整恢復了所有資訊;它只是讓「球往哪裡移動」成為可推測的問題。
reward 是現在的回覆,價值還要看未來
即使畫面已經足夠描述短期狀態,Agent 仍然不能只用這一步的分數判斷 action 好不好。假設向右移動後立刻得到 reward = 0,它可能什麼也沒做,也可能剛好把球拍移到下一球會落下的位置。這兩種結果要等未來幾步才分得出來。
把一個簡化的決策路徑寫出來就很清楚:
START
 ├─ SAFE → reward 1 → TERMINAL
 └─ WAIT → reward 0 → GOOD_STATE
                    └─ WAIT → reward 0 → FINISH
                              └─ FINISH → reward 3 → TERMINAL
reward 是環境此刻回傳的回饋;從現在開始把未來回饋累積起來的量叫做 return。未來通常不和現在同等重要,所以用 gamma 折扣:
G_t = r_(t+1) + gamma × r_(t+2) + gamma² × r_(t+3) + ...
如果 WAIT 後收到 [0, 0, 3],且 gamma = 0.9,它的 return 是 0 + 0.9 × 0 + 0.9² × 3 = 2.43,反而高於立刻得到 1 的 SAFE。這就是為什麼「這一步沒有得分」不等於「這個 action 沒有價值」。
Bellman Equation 把這種長期判斷改寫成較容易逐步更新的關係:目前選擇的價值,等於現在的 reward 加上折扣後的下一個 state 價值。對最佳 Q-value,可以寫成:
Q*(s, a) = E[r + gamma × max_a' Q*(s', a')]
Q(s, a) 問的是「在 state s 先做 action a,從現在往後平均有多好」,所以它和 immediate reward 不是同一個東西。當遊戲真的終止時,沒有下一個 state 可以接回來,target 只能保留目前 reward;當 episode 只是被外部時間限制截斷時,是否保留 bootstrap 必須依照訓練設計判斷,不能因為看到一個統稱 done 就無條件歸零。
這個區分看似細節,卻直接影響模型學到的目標:環境如何結束,決定了價值估計是否還能向下一個 state 延伸。
Q-value 一開始不知道,怎麼從互動中學出來?
Bellman Equation 說明價值之間應該如何互相連接,卻沒有直接告訴我們未知的 Q-value 要如何得到。先不把高維畫面和神經網路一起帶進來,可以用一個只有兩個 state 的小型環境追蹤完整的 tabular Q-Learning 更新。
來源版本以 episodes = 20、alpha = 0.1、gamma = 0.99、epsilon = 0.2、seed = 42 執行。唯一能拿到 reward 1 的路徑是 state 0 → RIGHT → state 1 → RIGHT → TERMINAL;任何 state 選 LEFT 都會結束而沒有回饋。實際 trace 的最後 Q-table 是:
state 0: LEFT=0.000000, RIGHT=0.027720
state 1: LEFT=0.000000, RIGHT=0.271000
greedy policy: state 0 -> RIGHT, state 1 -> RIGHT
這個結果先揭示了一個重要現象:state 0 的 RIGHT 在當下拿到的 reward 仍然是 0,最後卻變成正值。價值不是只從當下的分數產生,而是從下一個 state 已經學到的價值逐步往前傳。
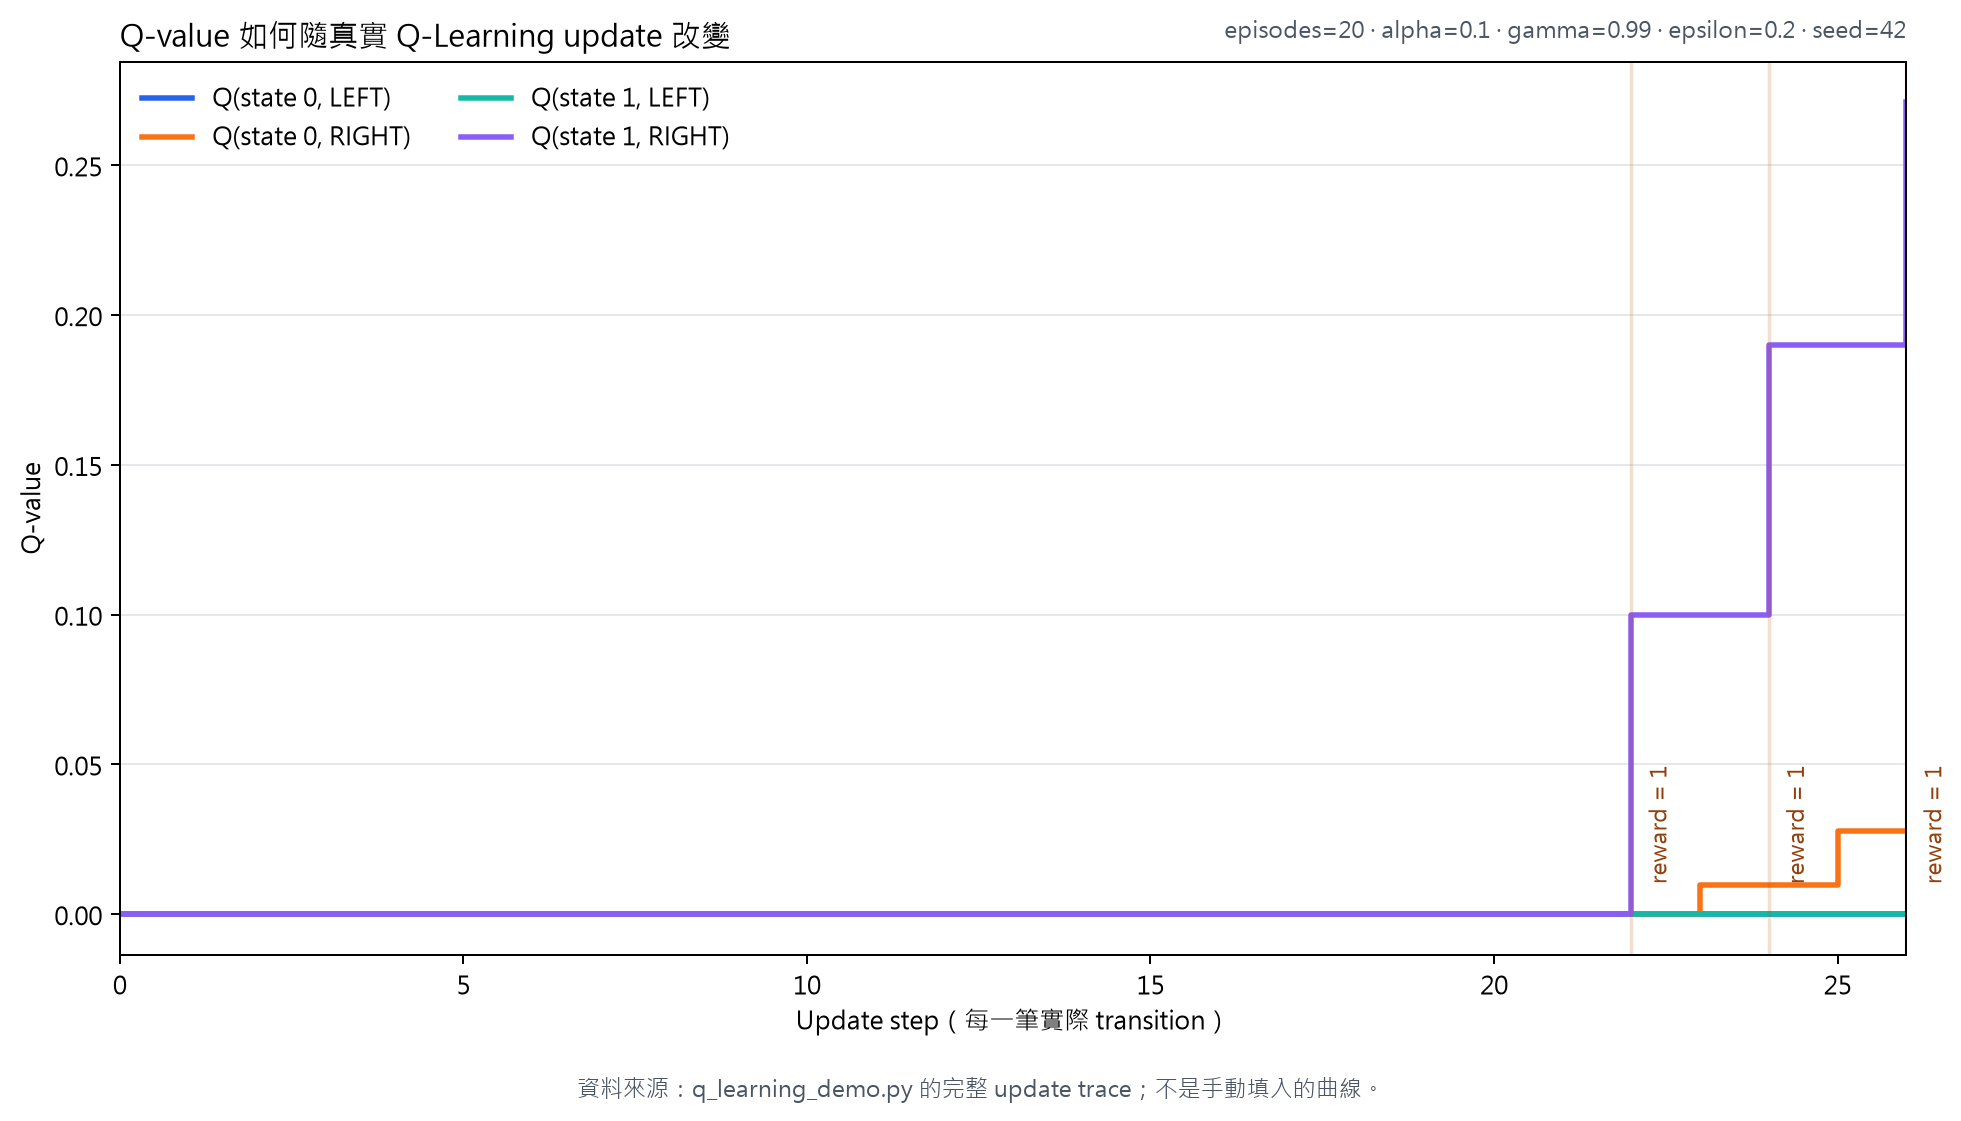
曲線來自完整 update trace,而不是手動填入的示意數字;圖中的設定是 20 個 episode、alpha=0.1、gamma=0.99、epsilon=0.2、seed=42。可以看到先得到終點 reward 的 state 1, RIGHT 上升,前一個 state 的 RIGHT 隨後才跟著上升。
把 episode 19、step 0 的一次更新拆開:目前 Q 是 0,這一步 reward 是 0,但下一個 state 的最大 Q-value 已經是 0.1。因此:
target   = 0 + 0.99 × 0.1 = 0.099
TD error = 0.099 - 0 = 0.099
updated Q = 0 + 0.1 × 0.099 = 0.0099
這裡的 TD error(Temporal-Difference error)只是「目前估計離這次 target 還有多遠」;alpha 則決定這次只向 target 移動多少。這個 update 不需要等整局遊戲結束,因為它可以先用目前對下一個 state 的估計來修正現在,這種做法叫做 bootstrap。
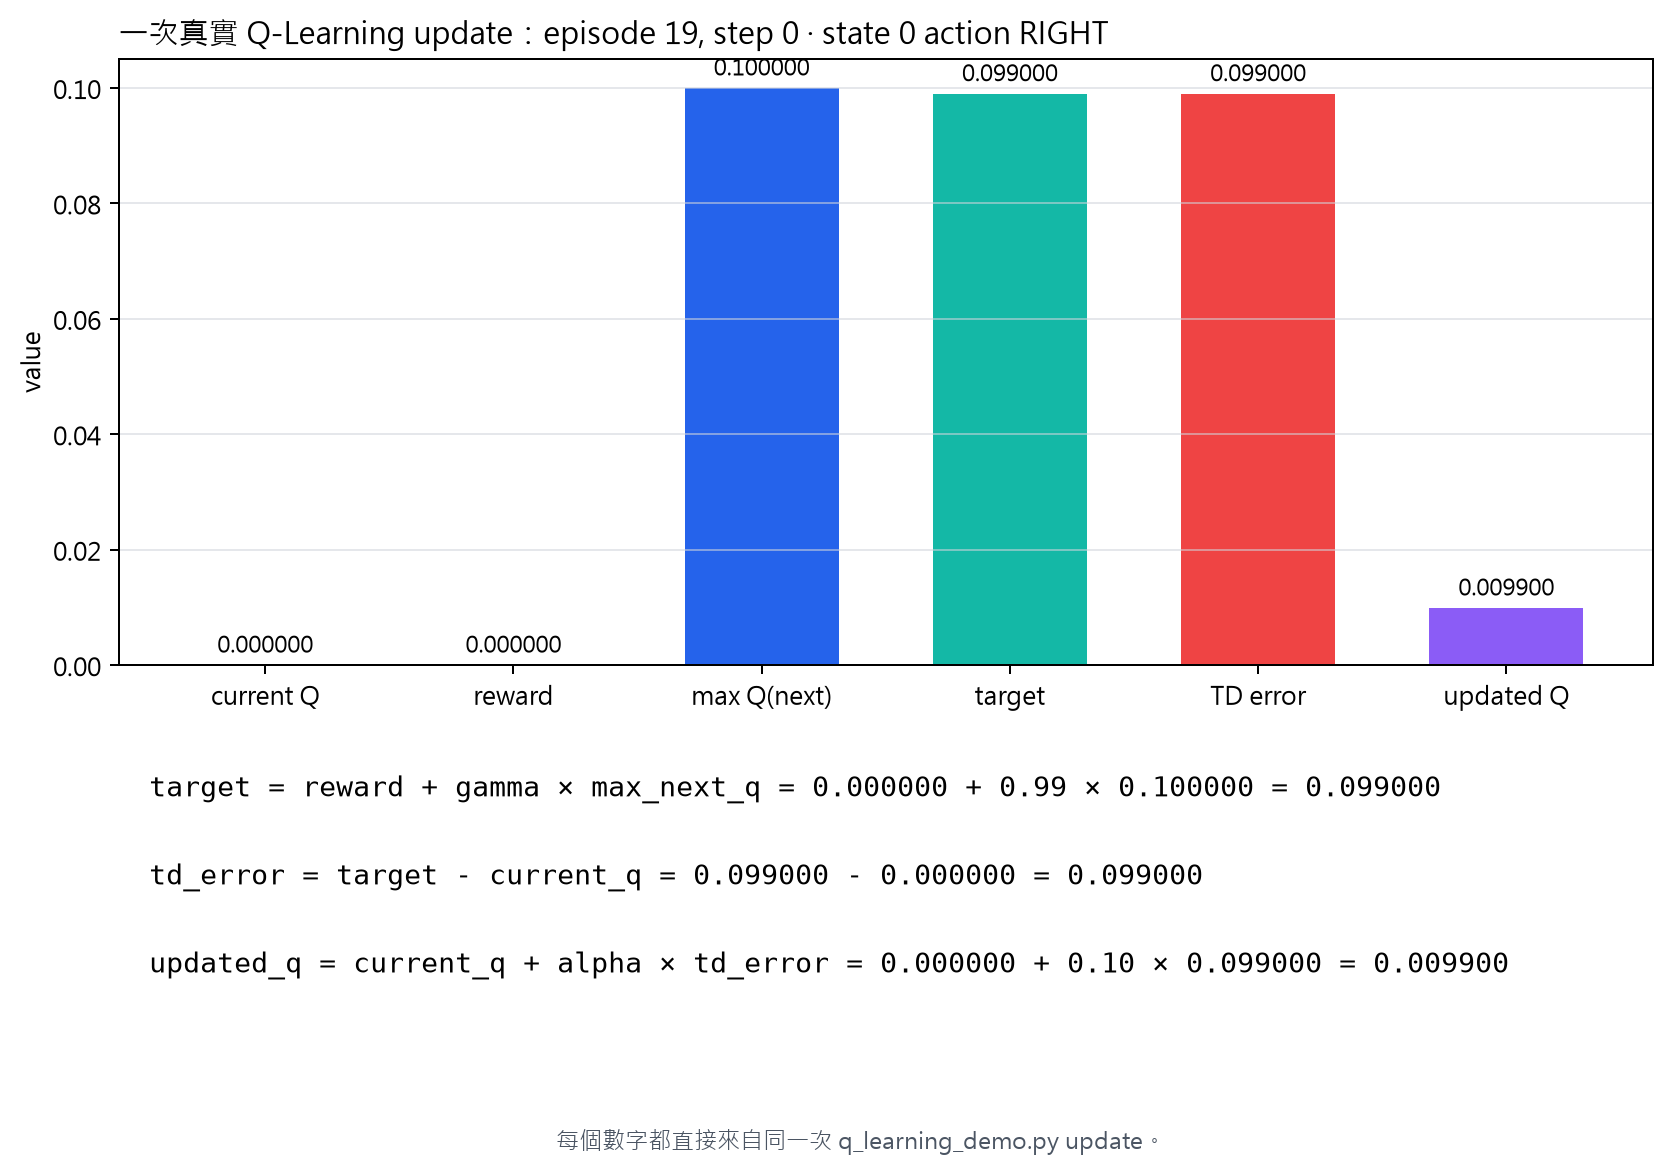
這張圖對應同一份 trace 的 episode 19、step 0:reward=0,但 max Q(next)=0.1,所以 target 是 0.099,更新後的 Q 是 0.0099。
在這個小環境中,Q-value 可以直接放在一張 Q-table 裡。Breakout 則不同:state 是 (4, 84, 84) 的連續像素組合,幾乎不可能為每一種畫面各存一格;即使畫面很相似,只要像素不完全相同,表格也不會自然共享經驗。
這就是 Deep Q-Learning 需要神經網路的原因。它沒有改掉 Q-value、reward 或 Bellman target 的定義,而是把「查表並修改一格」換成「讓 network 從畫面估計所有 action 的 Q-values」。因此 DQN 不是從另一套目標開始,而是把同一個價值學習問題搬到可以處理高維 observation 的表示方式上。
這個基礎建立了什麼,又還沒有證明什麼?
前六篇來源材料真正建立的是一份可以被檢查的前置契約:reset() 和 step() 的 transition 邊界固定了;觀察值從原始 RGB 畫面變成包含短期時間資訊的 (4, 84, 84);reward、return、terminated 和 truncated 的語意被分開;Q-Learning 也用固定 seed 的真實 trace 展示了「未來價值如何回傳到現在」。
但這些證據沒有證明 DQN 已經學會 Breakout,也沒有證明特定 preprocessing 一定是最佳選擇。小型 Q-Learning trace 只用來驗證更新機制;它不能代替 Atari 訓練、跨 seed 評估或模型比較。CNN 如何處理四張畫面、Experience Replay 如何打散互動資料、Target Network 如何穩定 target,以及完整 training loop 如何除錯,會留在後續 Core Series 文章處理。
這個邊界正是可靠工程的起點:在宣稱模型變好以前,先確定每一筆資料的意義沒有在環境、畫面處理和價值更新之間悄悄改變。
原始系列與可追溯證據
本文是對 Original Breakout Ironman Series Days 1–6 的 Editorial Distillation,不是把六篇文章依日期串接。原始文章保留了當時的開發順序與歷史語境;本文則以「一次互動如何變成可學習的價值」為中心重排內容。
來源版本固定在 breakout-rl-engineering commit f85038c。可直接核對的原始文章與產物包括:
- Environment 與 ALE/Gymnasium
- Transition、state、action 與 reward
- Preprocessing 與 frame stacking
- MDP、return 與 Bellman Equation
- Q-Learning 與 Q-value update
- 完整的 Q-Learning trace
- 原始 iThome 三十天系列
若要繼續往下讀,下一篇會從這份 (4, 84, 84) observation 開始,回答 CNN 如何把畫面轉成四個 action 的 Q-value;那是把「可靠的輸入與目標」接成「可訓練的 DQN」的下一個問題。