Below you will find pages that utilize the taxonomy term “LLM”
Posts
read more
從 SQL 到 Text-to-SQL:讓資料庫聽懂人話
公司、醫院、學校和政府每天都在累積資料,但「資料存在」不代表「每個人都能使用」。很多時候,我們知道自己想問什麼,卻不知道資料放在哪張表,也不知道該怎麼寫 SQL。
我的碩士論文研究的,就是如何讓使用者直接用自然語言提問,再由系統自動產生可以執行的 SQL。這項技術稱為 Text-to-SQL。
不過,在介紹我的方法之前,我想先從最基本的問題開始:資料庫到底長什麼樣子?SQL 又在做什麼?
先認識資料庫:表、欄位與資料列
關聯式資料庫可以想成一組彼此有關聯的試算表。假設一間商店有兩張表:
顧客表 customers
| customer_id | name | city |
|---|---|---|
| 101 | Amy | Taipei |
| 102 | Bob | Tainan |
訂單表 orders
| order_id | customer_id | amount |
|---|---|---|
| 9001 | 101 | 1200 |
| 9002 | 101 | 650 |
| 9003 | 102 | 800 |
直向的 name、city、amount 稱為欄位,描述資料具有哪些屬性;橫向的每一筆內容稱為資料列。整個資料庫有哪些表、欄位與型別,合起來稱為 Schema(資料庫結構)。
其中,customers.customer_id 是每位顧客不重複的編號,稱為主鍵。orders.customer_id 則指向顧客表中的同名編號,稱為外鍵。靠著這個關係,我們才知道訂單 9001 和 9002 都屬於 Amy。
真實資料庫當然比這複雜得多:可能有數十張表、數百個欄位,而且名稱常是縮寫。使用者只看到「顧客」和「訂單」,系統看到的卻可能是 cust_info、txn_hdr 和一大串編號。
SQL 是怎麼向資料庫提問的?
SQL(Structured Query Language)是操作關聯式資料庫的語言。若要找出住在台北的顧客,可以寫:
SELECT name
FROM customers
WHERE city = 'Taipei';
這三行可以直接讀成:
SELECT name:我要取得姓名。FROM customers:資料來自顧客表。WHERE city = 'Taipei':只保留城市為台北的資料。
如果問題改成「台北顧客總共下了幾筆訂單?」,就必須同時使用顧客表和訂單表:
Posts read more
Hugging Face Spaces 部署指南
前言
當你嘗試按照官方指引部署 Hugging Face Spaces 時:
git init
git add app.py requirements.txt
git commit -m "Initial commit"
git remote add origin https://huggingface.co/spaces/YOUR_USERNAME/mcp-sentiment
git push -u origin main
你可能會遇到各種錯誤。本指南將帶你逐步解決這些問題,並成功部署到 Hugging Face Spaces。
為什麼原始指令無法運作?
自 2023 年 10 月 1 日起,Hugging Face 停止支援密碼身分驗證,因此當你使用 HTTPS URL 推送時,會收到以下錯誤訊息:
Posts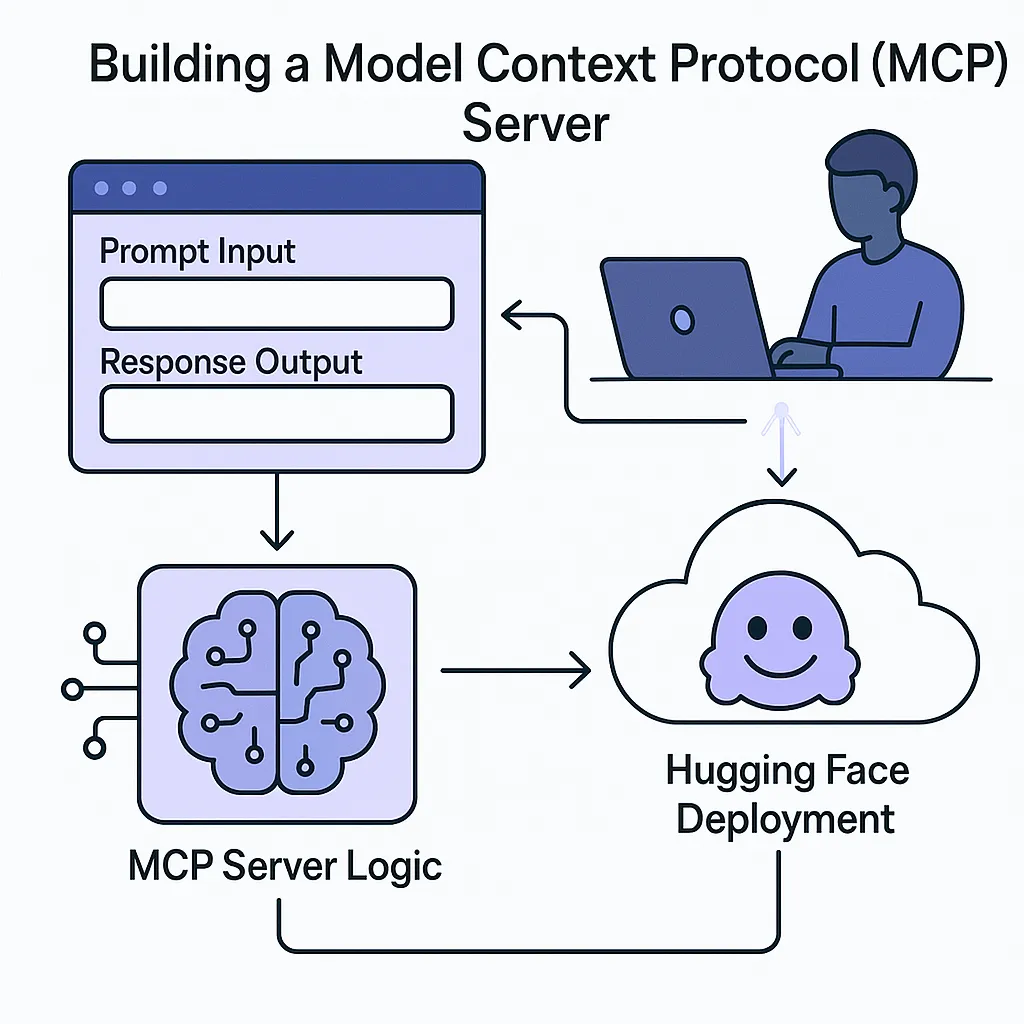 read more
使用 Gradio MCP 建立伺服器,并部署在Hugging Face Space
Gradio MCP 整合介紹
Gradio 透過自動將您的 Python 函數轉換為 MCP 工具,提供了一種簡單的方式來創建 MCP 伺服器。當您在 launch() 中設置 mcp_server=True 時,Gradio 會:
- 自動將您的函數轉換為 MCP 工具
- 將輸入元件映射到工具參數架構
- 從輸出元件確定回應格式
- 設置 JSON-RPC over HTTP+SSE 進行客戶端-伺服器通訊
- 創建網頁介面和 MCP 伺服器端點
專案設置
首先,讓我們為專案創建一個新目錄並設置所需的依賴項:
# Windows

mkdir mcp-sentiment
cd mcp-sentiment
python -m venv venv
source venv/bin/activate
pip install "gradio[mcp]" textblob
創建伺服器
Hugging Face Spaces 需要一個 app.py 檔案來建立 space,所以 Python 檔案的名稱必須是 app.py 創建一個名為 app.py 的新檔案,包含以下程式碼:


Posts
read more
MCP 通信協議
MCP 通信協議
MCP 定義了一套標準化的通信協議,使客戶端和服務器能夠以一致、可預測的方式交換資訊。這種標準化對於整個社區的互操作性至關重要。
JSON-RPC:基礎架構
MCP 的核心使用 JSON-RPC 2.0 作為客戶端和服務器之間所有通信的消息格式。JSON-RPC 是一種輕量級的遠程過程調用協議,以 JSON 編碼。
JSON-RPC 特點
- 📜 人類可讀性強,易於調試
- 🌍 語言無關性,支援在任何編程環境中實現
- 🔒 成熟穩定,具有清晰的規範和廣泛的採用
三種消息類型
MCP 使用三種基本消息類型進行通信:

1.請求(Requests)
從客戶端發送到服務器以啟動操作。請求消息包括唯一標識符、要調用的方法名稱和方法的參數(如果有)。
{
  "jsonrpc": "2.0",
  "id": 1,
  "method": "tools/call",
  "params": {
    "name": "weather",
    "arguments": {
      "location": "San Francisco"
    }
  }
}
2.響應(Responses)
從服務器發送到客戶端以回覆請求。響應消息包括與相應請求相同的 id 和 result(成功時)或 error(失敗時)。


Posts read more
🎯 Model Context Protocol (MCP) 基礎概念
爲什麽不能單靠LLM來解決事情
雖然大型語言模型(LLM)能憑訓練語料生成近似人類的回答,但它若缺乏對外部世界的即時存取,就難以讀取企業專屬資料或主動執行工具操作。
📋 MCP 概述:AI 應用程式的 USB-C
Model Context Protocol (MCP) 正在重新定義 AI 應用程式與外部世界的互動方式。作為由 Anthropic 在 2024 年底推出的開放標準,MCP 解決了長期困擾 AI 開發者的整合複雜性問題,為整個生態系統帶來了前所未有的標準化和互操作性。
🎯 什麼是 Model Context Protocol?
Model Context Protocol 是一個開放的通信協議,專門設計用於標準化 AI 模型與外部數據源、工具和服務之間的交互。該協議建立在 JSON-RPC 2.0 基礎之上,提供了一個輕量級、可擴展的框架,使 AI 應用程式能夠安全、高效地存取外部資源。